
NVIDIA Vera Rubin platforma dominuoja MLPerf Training ir Endpoints palyginimuose
Vaizdas: NVIDIA · Šaltinis
NVIDIA naujoji Vera Rubin platforma pirmauja MLPerf Training v6.1 palyginimuose visose kategorijose ir užtikrina daugiau nei 10 kartų efektyvumo prieaugį MLPerf Endpoints agentinės dirbtinio intelekto pralaidumo vienam vatui rodiklyje.
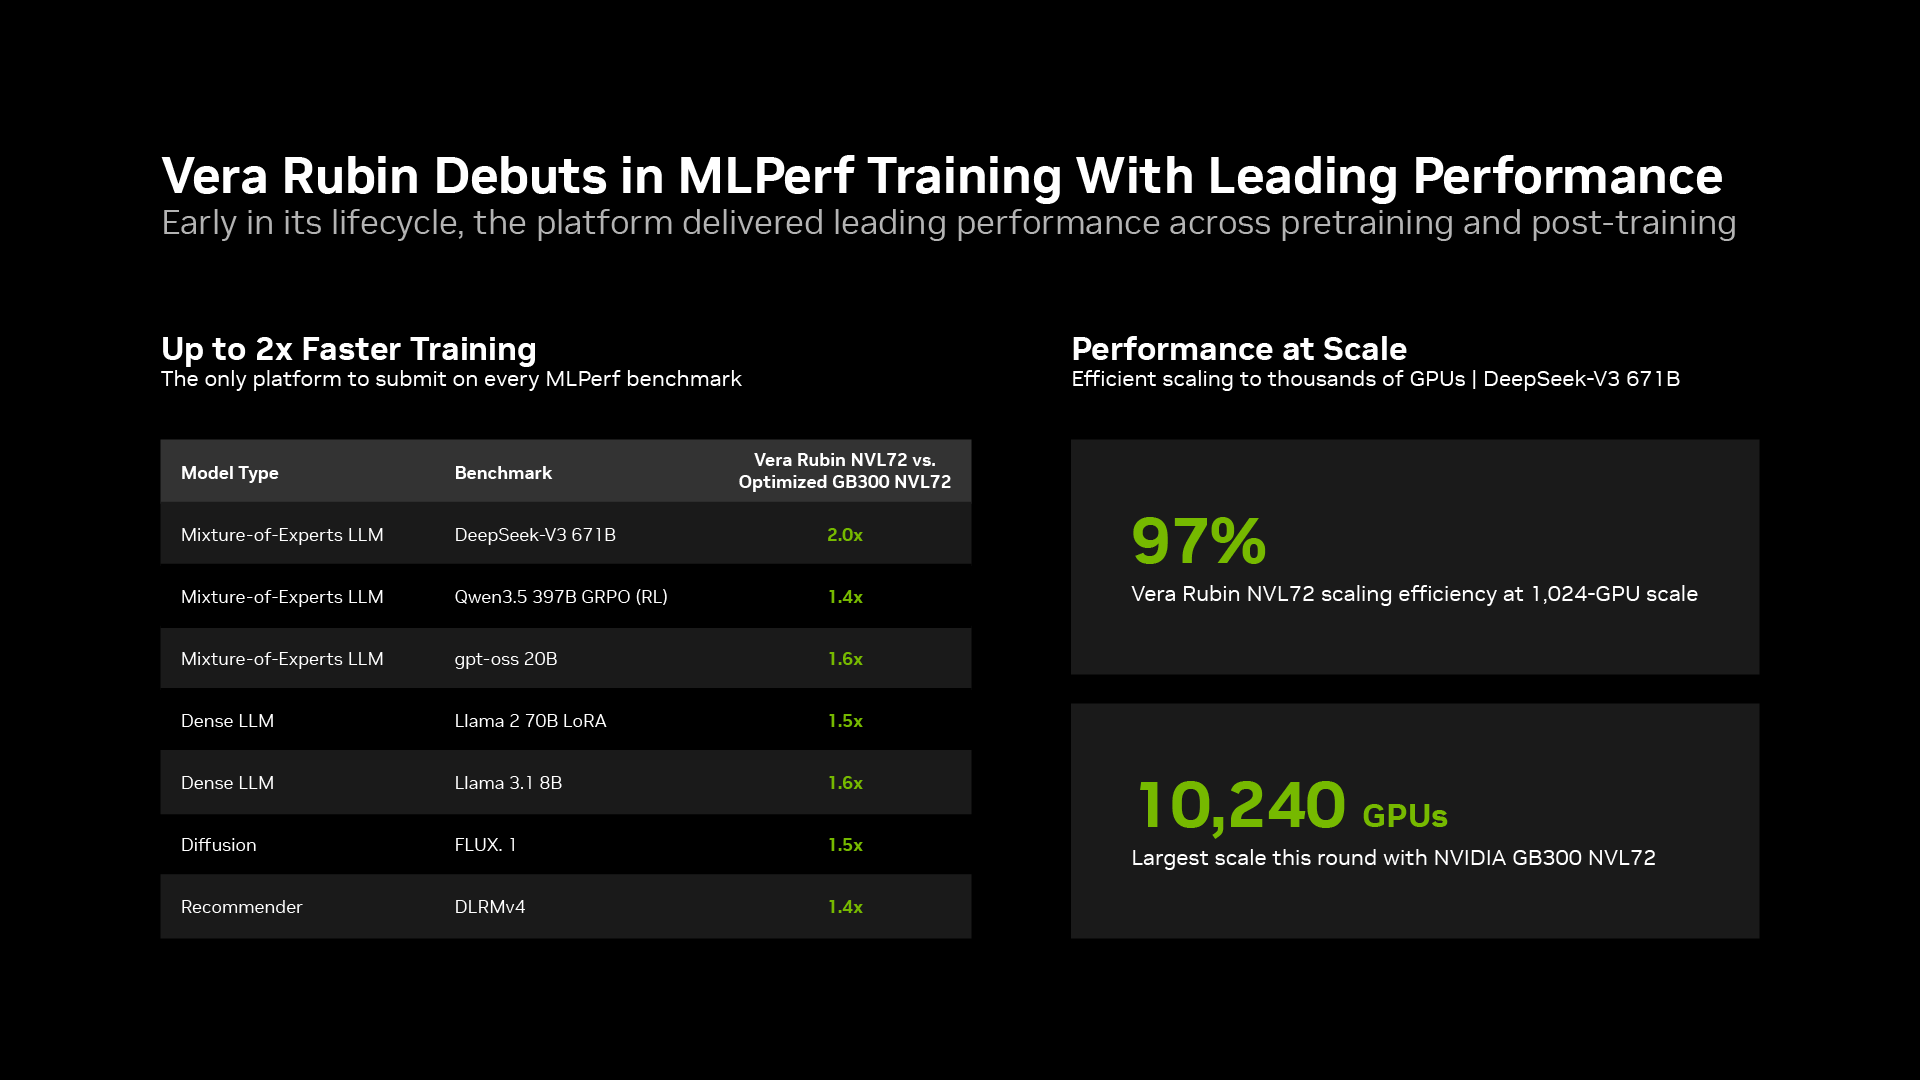
NVIDIA pasiekė įspūdingą pergalę su savo Vera Rubin platforma naujausiuose MLPerf palyginimuose, pažymėdama stiprią debiutą tiek mokymo, tiek spėjimo našumo metrikose. Neseniai paskelbtuose MLPerf Training v6.1 palyginimuose NVIDIA Vera Rubin sistema buvo vienintelė, pateikusi rezultatus kiekviename teste, apimančiame didelius kalbos modelius, vaizdų generavimą, rekomendacijų sistemas ir stiprinamojo mokymosi post-mokymą. Ji pasižymėjo iki dvigubo našumo vienam GPU, lyginant su labai optimizuota NVIDIA GB300 sistema, išryškindama greitus kartos pažangumus jų aparatinėje ir programinėje įrangoje.
Mastelį demonstravo Vera Rubin, ypač DeepSeek-V3 teste, kur sistema išlaikė apie 97 % skalavimo efektyvumą nuo 256 iki 1 024 GPU, sutrumpindama mokymo laiką nuo 16 minučių iki maždaug keturių minučių. NVIDIA taip pat rodė mokymą milžiniškomis apimtimis: GB300 sistemos naudojo 10 240 GPU - didžiausią šio turo mastą, kuriam prilygo Microsoft Azure su GB200 sistemomis. Tai pabrėžia efektyvų kelių GPU koordinavimą, pasiektą naudojant NVIDIA NVLink mastelio didinimo tinklą sistemose ir Quantum-X800 InfiniBand bei Spectrum-X Ethernet mastelio išdidinimo tinklą duomenų centruose.
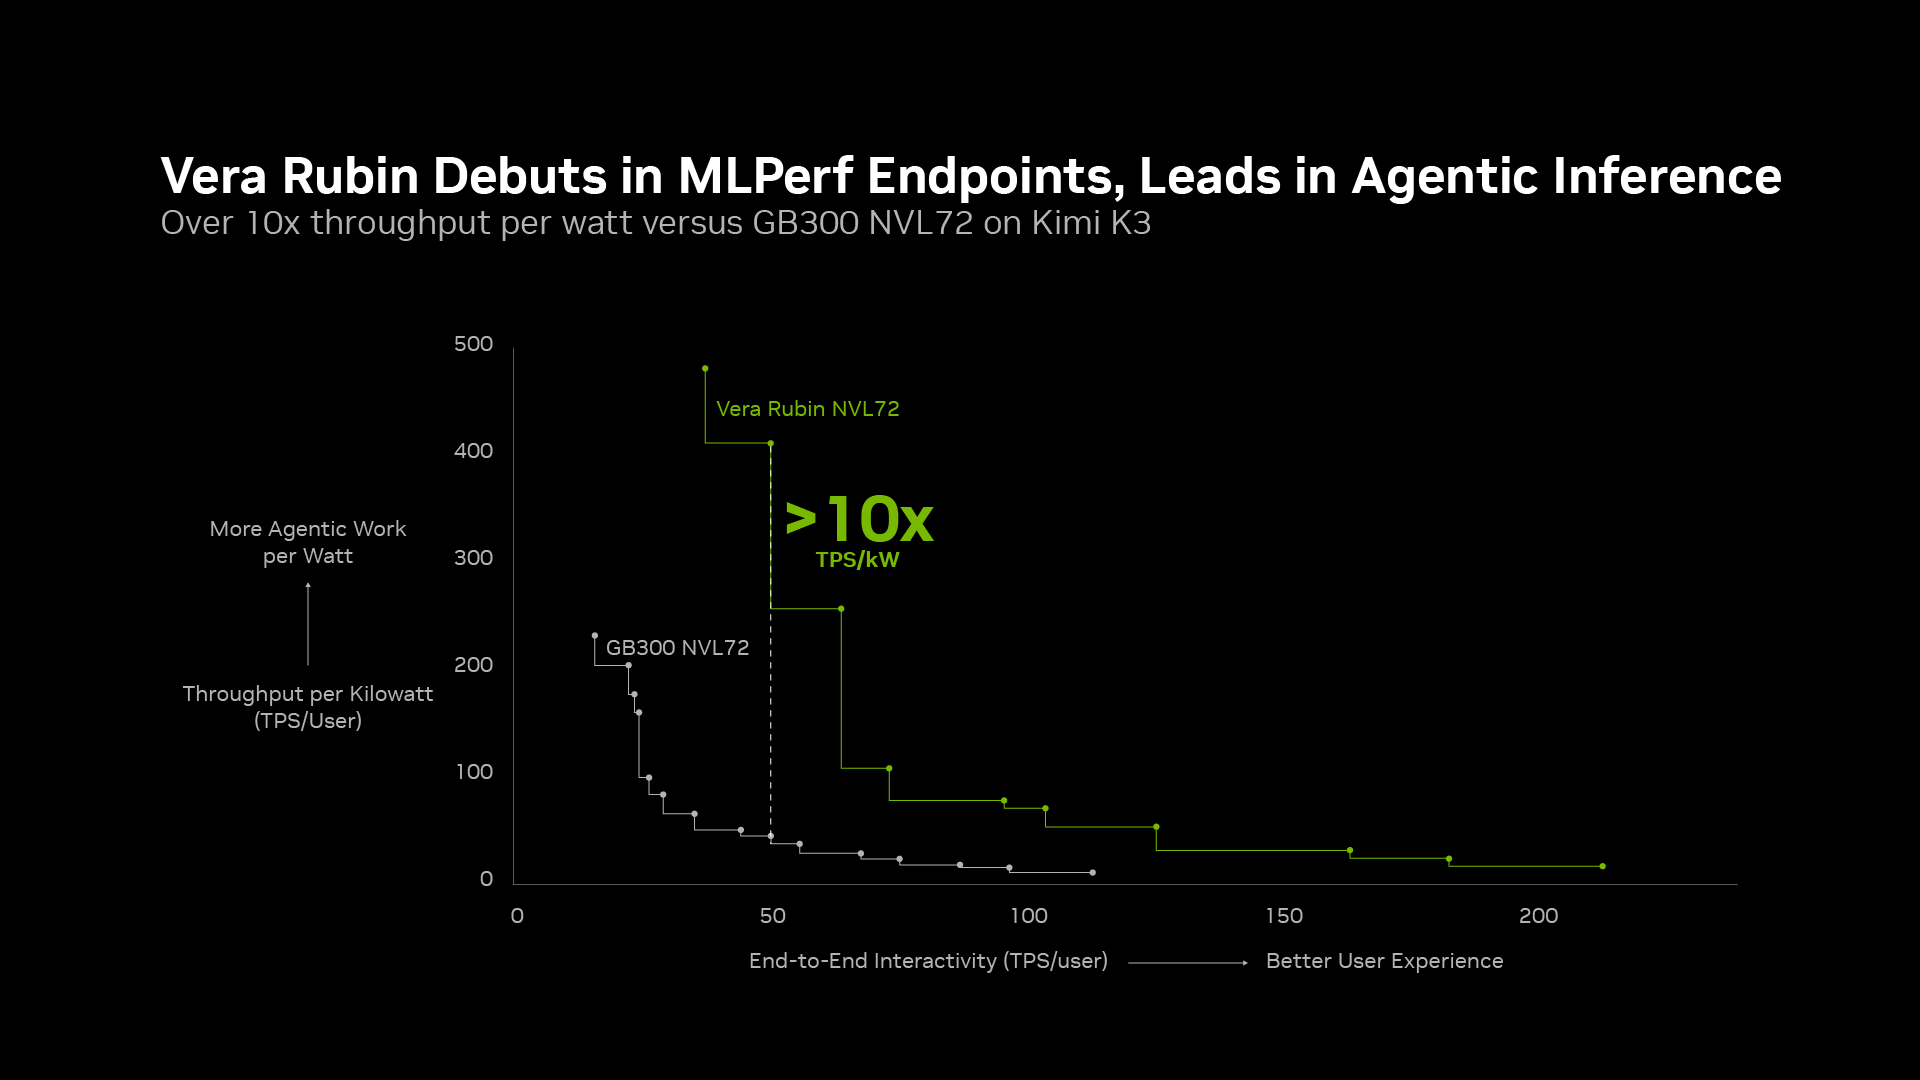
Pirma kartą NVIDIA MLPerf Endpoints, orientuotame į agentinį DI spėjimą, Vera Rubin platformos užtikrino daugiau nei dešimtkartinį pralaidumo prie vieno vato pagerėjimą, palyginti su ankstesnės kartos sistemomis, tokiomis kaip GB300, išlaikant atsako vėlinimus. Tai svarbu, nes agentinės DI užduotys dažnai reikalauja daugiamatės dedukcijos ir daugkartinių įrankių iškvietimų, generuojant daug žetonų kiekvienam atliktam veiksmui. Didesnis žetonų generavimas vienam vatui reiškia, kad duomenų centrai gali vienu metu aptarnauti daugiau DI agentų mažesnėmis energijos sąnaudomis.
NVIDIA partnerių ekosistema vaidino svarbų vaidmenį šiame pasiekime, rezultatus pateikė 20 organizacijų, įskaitant Asus, Cisco, Dell Technologies, Google Cloud, HPE, Oracle, Supermicro ir kt. Šie indėliai atspindi NVIDIA CUDA pagrįsto programinės įrangos rinkinio universalumą ir optimizavimo potencialą kartu su naujausia aparatine architektūra.
Be MLPerf, Vera Rubin taip pat pirmauja nepriklausomuose DI agentų palyginimuose, tokiuose kaip SemiAnalysis AgentX ir Artificial Analysis AgentPerf, patvirtindama savo galimybes pre-mokymuose, post-mokymuose ir agentinio spėjimo užduotyse. Ji taip pat palaiko didelio našumo skaičiavimų reikalavimus, kaip parodyta neseniajame SC26 konferencijoje. NVIDIA nurodo, kad nuolatiniai programinės įrangos optimizavimai dar labiau pagerins Vera Rubin našumą, žadėdami nuolatinį vertės augimą klientams, investuojantiems į šią infrastruktūrą.
Išsamias technines įžvalgas galima rasti NVIDIA MLPerf Training ir MLPerf Endpoints tinklaraščiuose, kuriuose pateikiama išsami analizė apie pasiektus palyginimo rezultatus ir sistemos konfigūracijas. Vera Rubin platforma tvirtai nustato NVIDIA lyderystę AI mokymo ir spėjimo spartinime mastu, derindama energijos efektyvumą su neprilygstamu pralaidumu ir skalavimu.
Šaltiniai ir originalūs pranešimai
Skaityti originalų šaltinį ↗
Komentarai (0)
Komentarų dar nėra. Pradėkite diskusiją.
Rašyti komentarą
Komentarai publikuojami po moderavimo. Jūsų vardas ir komentaras bus vieši. Paskyra