
NVIDIA Vera Rubin-Plattform dominiert MLPerf Training- und Endpoints-Benchmarks
Image: NVIDIA · Source
Die neue Vera Rubin-Plattform von NVIDIA führt die MLPerf Training v6.1-Benchmarks in allen Kategorien an und liefert über zehnfache Effizienzsteigerungen bei der KI-Agentendurchsatzleistung pro Watt in MLPerf Endpoints.
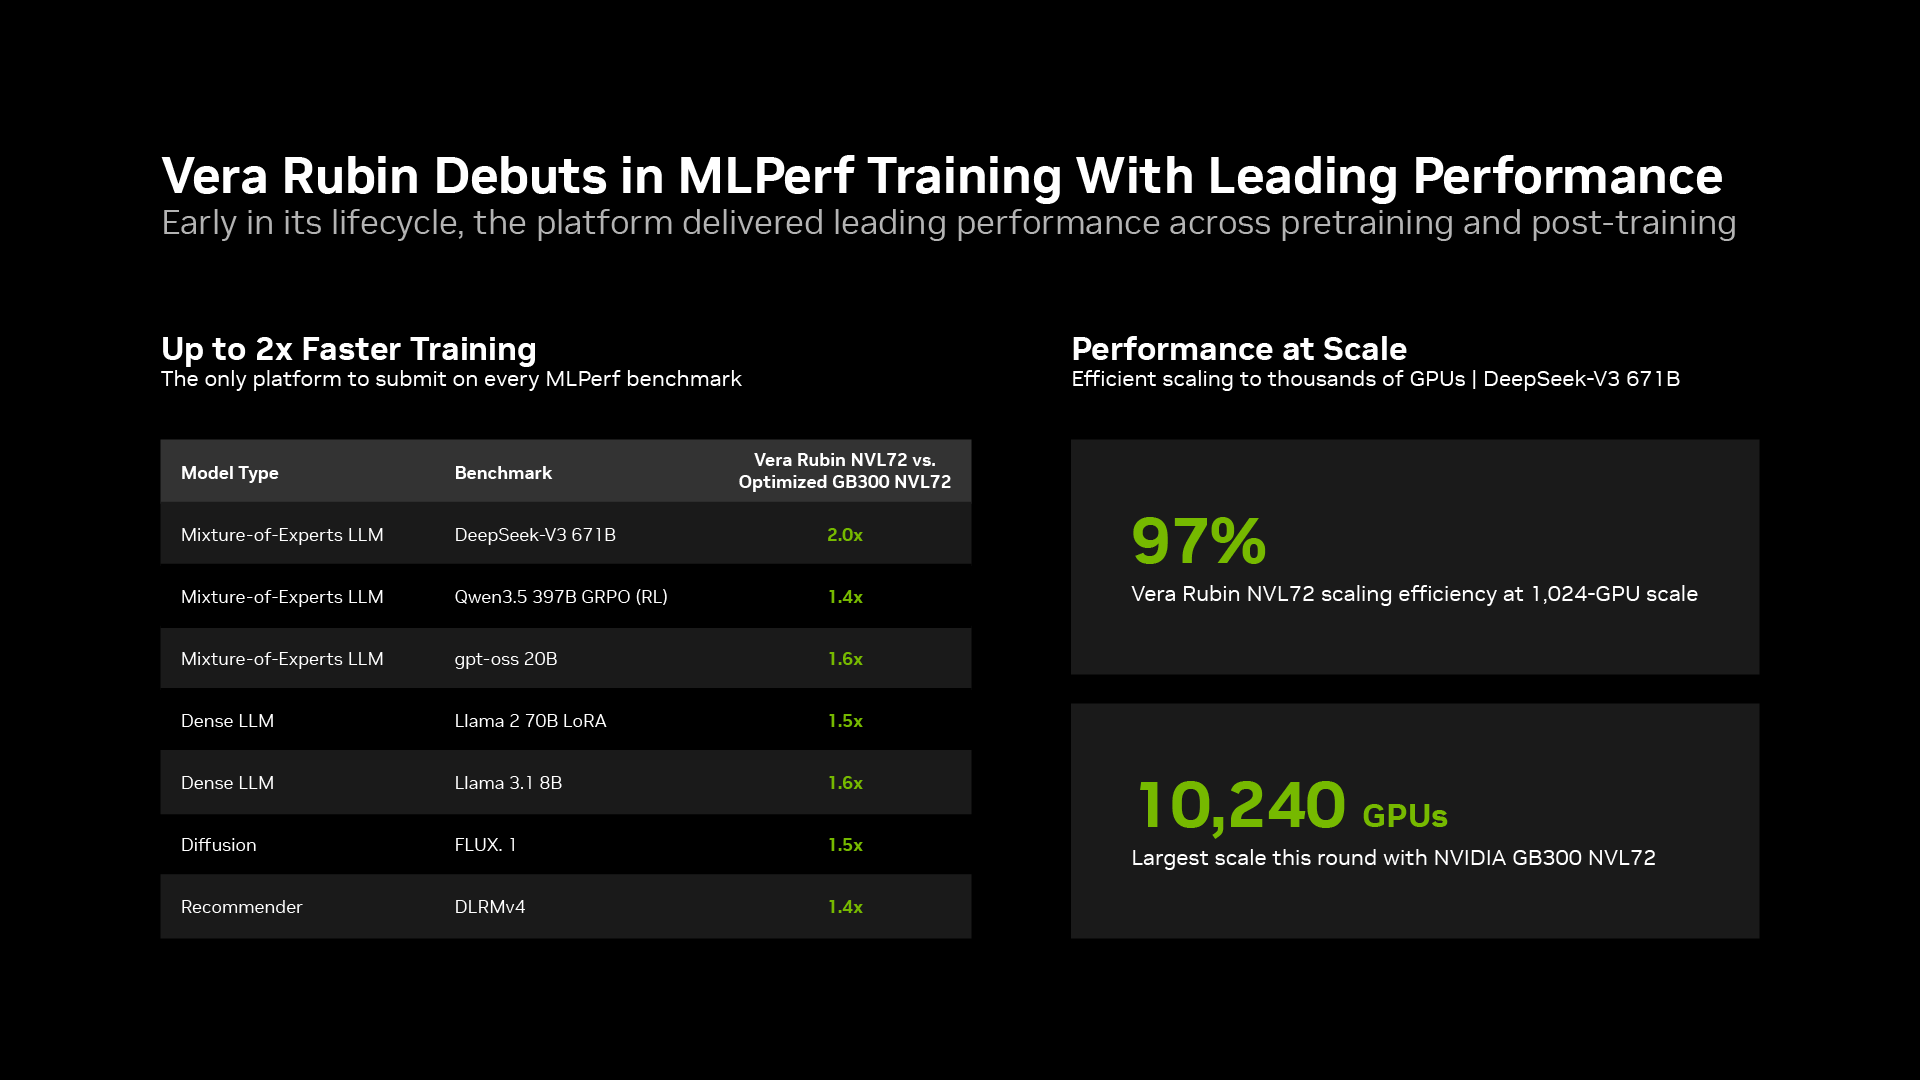
NVIDIA hat mit seiner Vera Rubin-Plattform einen durchschlagenden Erfolg in den neuesten MLPerf-Benchmark-Ergebnissen erzielt und damit ein starkes Debüt sowohl bei Trainings- als auch bei Inferenzleistungskennzahlen gegeben. In den kürzlich veröffentlichten MLPerf Training v6.1-Benchmarks war das Vera Rubin-System von NVIDIA die einzige Plattform, die Ergebnisse für alle Benchmarks vorlegte, darunter große Sprachmodelle, Bildgenerierung, Empfehlungssysteme und Verstärkendes Lernen nach dem Training. Es erzielte bis zu doppelt so viel Leistung pro GPU im Vergleich zum hochoptimierten NVIDIA GB300-System und unterstreicht damit rasche Generationenverbesserungen in Hardware und Software.
Skalierbarkeit war ein Highlight für Vera Rubin, besonders beim DeepSeek-V3-Benchmark, bei dem das System eine Skalierungseffizienz von etwa 97 % von 256 bis 1.024 GPUs beibehielt, wodurch die Trainingszeit von 16 auf etwa vier Minuten sank. NVIDIA zeigte auch Trainings in massivem Maßstab: GB300-Systeme führten Benchmarks mit 10.240 GPUs durch, die größte in dieser Runde beobachtete Skalierung, die von Microsoft Azure mit GB200-Systemen erreicht wurde. Dies unterstreicht die Bedeutung einer effizienten Multi-GPU-Koordination, die durch NVIDIAs NVLink-Skalierungsnetzwerk innerhalb der Systeme sowie Quantum-X800 InfiniBand- und Spectrum-X Ethernet-Skalierungsnetzwerke zwischen Rechenzentren erreicht wird.
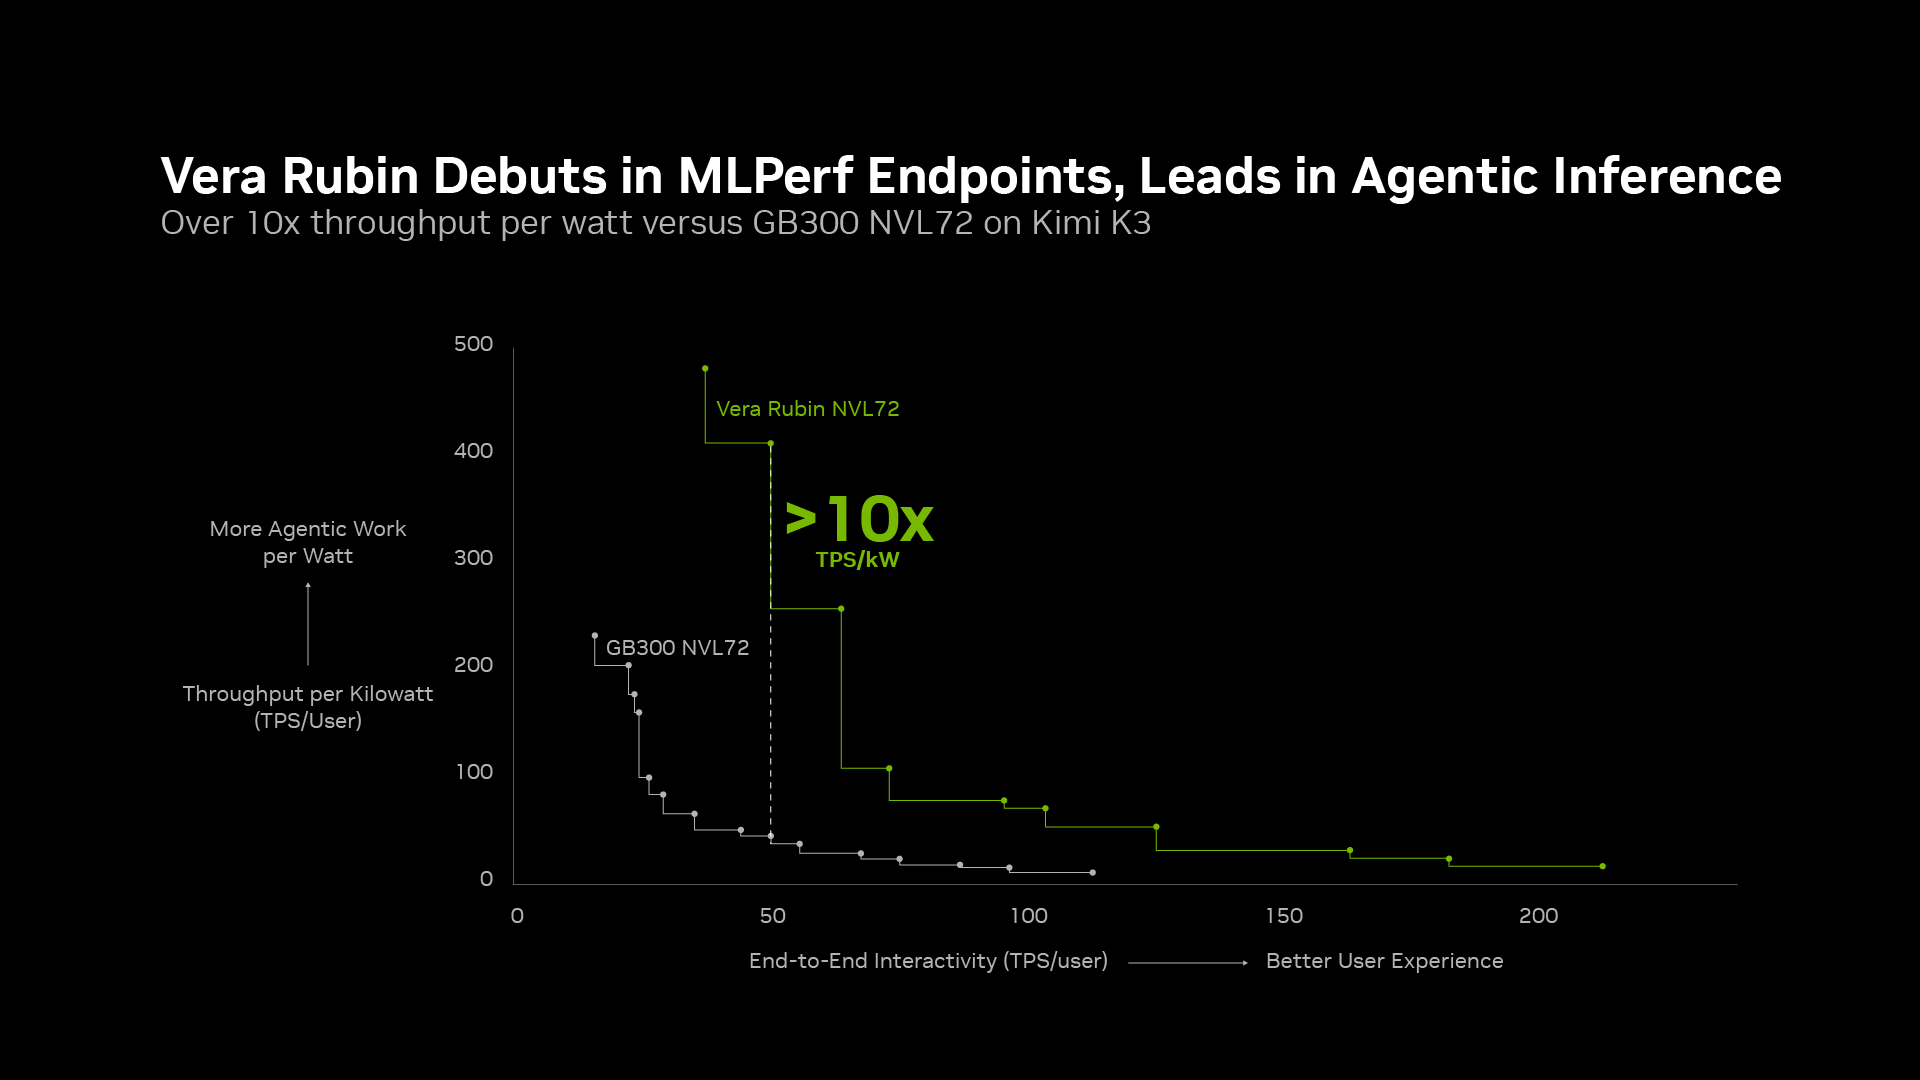
Zum ersten Mal bei NVIDIA in MLPerf Endpoints, das auf agentenbasierte KI-Inferenzarbeiten abzielt, lieferten Vera Rubin-Plattformen eine mehr als zehnfache Verbesserung des Durchsatzes pro Watt im Vergleich zu Systemen der Vorgängergeneration wie dem GB300, während die Antwortlatenzen erhalten blieben. Dies ist entscheidend, da agentenbasierte KI-Aufgaben oft mehrstufiges Denken und wiederholte Werkzeugaufrufe erfordern, wodurch viele Tokens für jede abgeschlossene Aktion generiert werden. Eine höhere Token-Erzeugung pro Watt bedeutet, dass Rechenzentren mehr KI-Agenten gleichzeitig bei niedrigeren Stromkosten bedienen können.
Das Partner-Ökosystem von NVIDIA spielte eine wichtige Rolle bei diesen Erfolgen, mit Einreichungen von 20 Organisationen darunter Asus, Cisco, Dell Technologies, Google Cloud, HPE, Oracle, Supermicro und anderen. Diese Beiträge spiegeln die Vielseitigkeit und das Optimierungspotenzial von NVIDIAs CUDA-basiertem Software-Stack in Kombination mit der neuesten Hardwarearchitektur wider.
Über MLPerf hinaus führt Vera Rubin auch bei unabhängigen KI-Agenten-Benchmarks wie SemiAnalysis AgentX und Artificial Analysis AgentPerf, was seine Leistungsfähigkeit bei Pre-Training-, Post-Training- und agentenbasierten Inferenz-Arbeitslasten bestätigt. Zudem unterstützt es Anforderungen an Hochleistungsrechnen, wie auf der kürzlichen SC26-Konferenz gezeigt wurde. NVIDIA weist darauf hin, dass kontinuierliche Softwareoptimierungen die Leistung von Vera Rubin weiter steigern und somit einen fortlaufenden Mehrwert für Kunden bieten werden, die in diese Infrastruktur investieren.
Für detaillierte technische Einblicke bieten NVIDIAs MLPerf Training- und MLPerf Endpoints-Blogs umfassende Analysen der Benchmark-Erfolge und der zugrundeliegenden Systemkonfigurationen. Die Vera Rubin-Plattform etabliert NVIDIAs Führungsposition bei der Beschleunigung von KI-Training und -Inference im großen Maßstab und verbindet Energieeffizienz mit unvergleichlichem Durchsatz und Skalierbarkeit.
Quellen und Originalberichte
Read the original source ↗
Kommentare (0)
Noch keine Kommentare.
Kommentar schreiben
Kommentare erscheinen nach Moderation. Name und Kommentar werden öffentlich angezeigt. Konto