
Google bringt zwei neue spezialisierte TPUs zur Verbesserung von KI-Workloads auf den Markt
Image: TPU 8tx and TPU 8i Max · Source
Google erweitert seine achte Generation von Tensor Processing Units (TPU) mit dem TPU 8tx für vertrauliches KI-Modelltraining und dem TPU 8i Max mit erhöhter Speicherkapazität, um Sicherheitsanforderungen und große Kontextfenster in KI-Anwendungen zu adressieren.
Google hat zwei neue Ergänzungen zu seinem Portfolio der achten Generation von Tensor Processing Units (TPU) angekündigt, die die Fähigkeiten für verschiedene KI-Workload-Bedürfnisse verbessern. Der TPU 8tx und der TPU 8i Max bringen spezialisierte Hardwarefunktionen, die sich jeweils auf sicheres Modelltraining und größere Speicherkapazität konzentrieren.
Der TPU 8tx, in Zusammenarbeit mit AMD entwickelt, baut auf dem TPU 8t-Chip auf und ist für vertrauliche Inferenz und Training ausgelegt. Dieser Chip verfügt über Hardware-Sicherheit, die sensible Daten und Modellgewichte selbst während aktiver Nutzung schützt, eine wichtige Eigenschaft für regulierte Unternehmen und Regierungsstellen, die proprietäre oder klassifizierte Informationen verarbeiten. Das Chip-Design unterstützt gleichzeitige Inferenz und Training, wodurch Organisationen Modelle auf privaten Daten feinjustieren können, ohne diese Daten zwischen Geräten zu übertragen, was die Datensicherheit und Betriebseffizienz erhöht.
Im Gegensatz dazu adressiert der TPU 8i Max Herausforderungen, die durch KI-Workloads mit enormen Kontextfenstern entstehen. Durch die Kombination von zwei TPU 8i-Inferenzchips in einem einzigen Paket verdoppelt der TPU 8i Max Speicher, Rechenleistung und Bandbreite. Dieses Design ermöglicht es KI-Modellen, umfangreichere Datensätze und komplexe Anfragen effektiv zu bewältigen, während die höchste Rechendichte pro Rack bereitgestellt wird, sodass Rechenzentren die Rechenleistung erhöhen können, ohne zusätzliche physische Fläche zu benötigen.
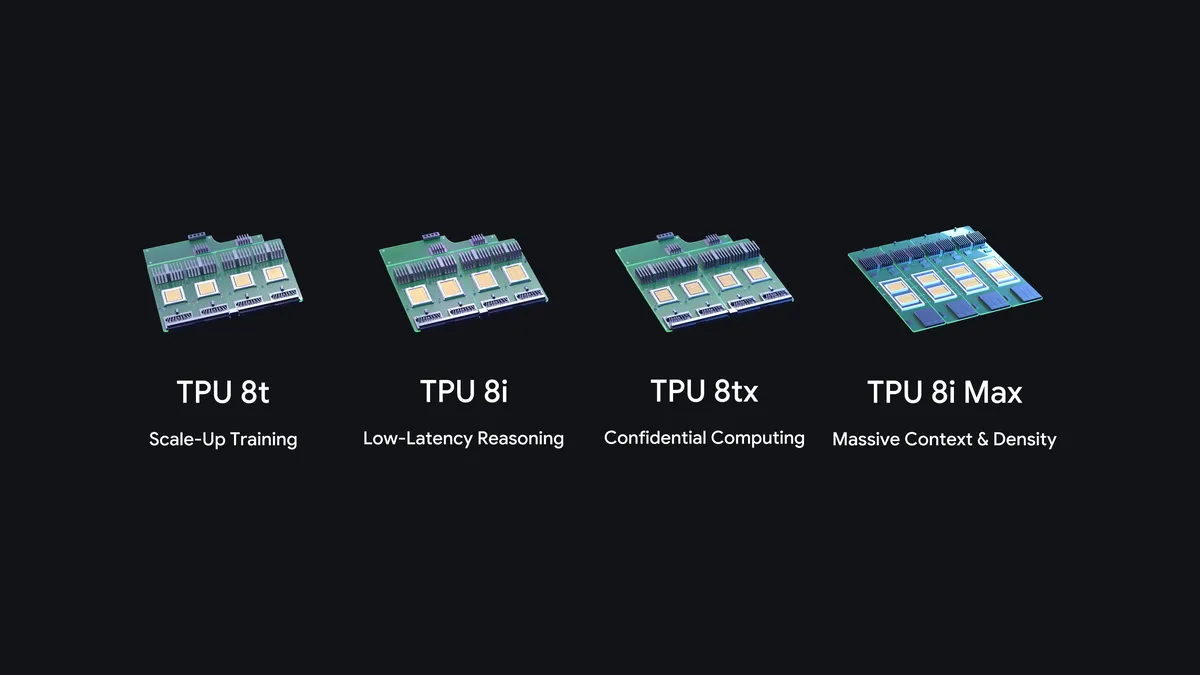
Das TPU-Portfolio von Google umfasst nun vier Systeme für verschiedene Phasen der KI-Entwicklung: TPU 8t für großflächiges Training, TPU 8i für latenzarmes Schließen, TPU 8tx für sicheres Computing und TPU 8i Max für umfangreiches Kontextmanagement. Dieses erweiterte Sortiment spiegelt Googles Ansatz wider, modulare Hochleistungs-KI-Hardware zu bauen, die in ein flexibles Systemdesign mit Hochgeschwindigkeitsnetzwerken, Speicher und Sicherheitskomponenten integriert ist.
Um eine breitere Entwicklerakzeptanz zu fördern, hat Google die Zugänglichkeit der TPUs verbessert. Zu den jüngsten Entwicklungen gehören native Unterstützung für beliebte Frameworks wie PyTorch und Hugging Face, die Open-Source-Bereitstellung von Softwaretools zur einfacheren Hardwareintegration sowie Leistungsoptimierungen, die erstklassige Ergebnisse bei Benchmarks ermöglichen, die reale KI-Workloads simulieren.
Diese Fortschritte erfolgen vor dem Hintergrund eines wachsenden Trends, bei dem große Technologieunternehmen und KI-Forschungslabore spezialisierte KI-Chips entwickeln, um die Abhängigkeit von traditionellen GPU-Anbietern zu verringern. Google betont, dass diese neuen TPU-Systeme nicht nur Forschungs- und kommerzielle KI-Projekte unterstützen, sondern auch zu einem agilen Hardware-Software-Ökosystem beitragen, das für sich entwickelnde KI-Anforderungen ausgelegt ist.
Für weitere Details zu diesen TPU-Systemen hat Google technische Ressourcen bereitgestellt und eine Sendung, die ihre Architektur und Fähigkeiten auf der Google Cloud-Plattform erläutert.
Quellen und Originalberichte
Read the original source ↗
Kommentare (0)
Noch keine Kommentare.
Kommentar schreiben
Kommentare erscheinen nach Moderation. Name und Kommentar werden öffentlich angezeigt. Konto