
NVIDIA Vera Rubin -alusta hallitsee MLPerf Training ja Endpoints vertailuja
Kuva: NVIDIA · Lähde
NVIDIAn uusi Vera Rubin -alusta johtaa MLPerf Training v6.1 -vertailuja kaikissa kategorioissa ja tarjoaa yli 10-kertaiset tehokkuushyödyt MLPerf Endpoints agenttipohjaisen tekoälyn läpimenolle wattia kohti.
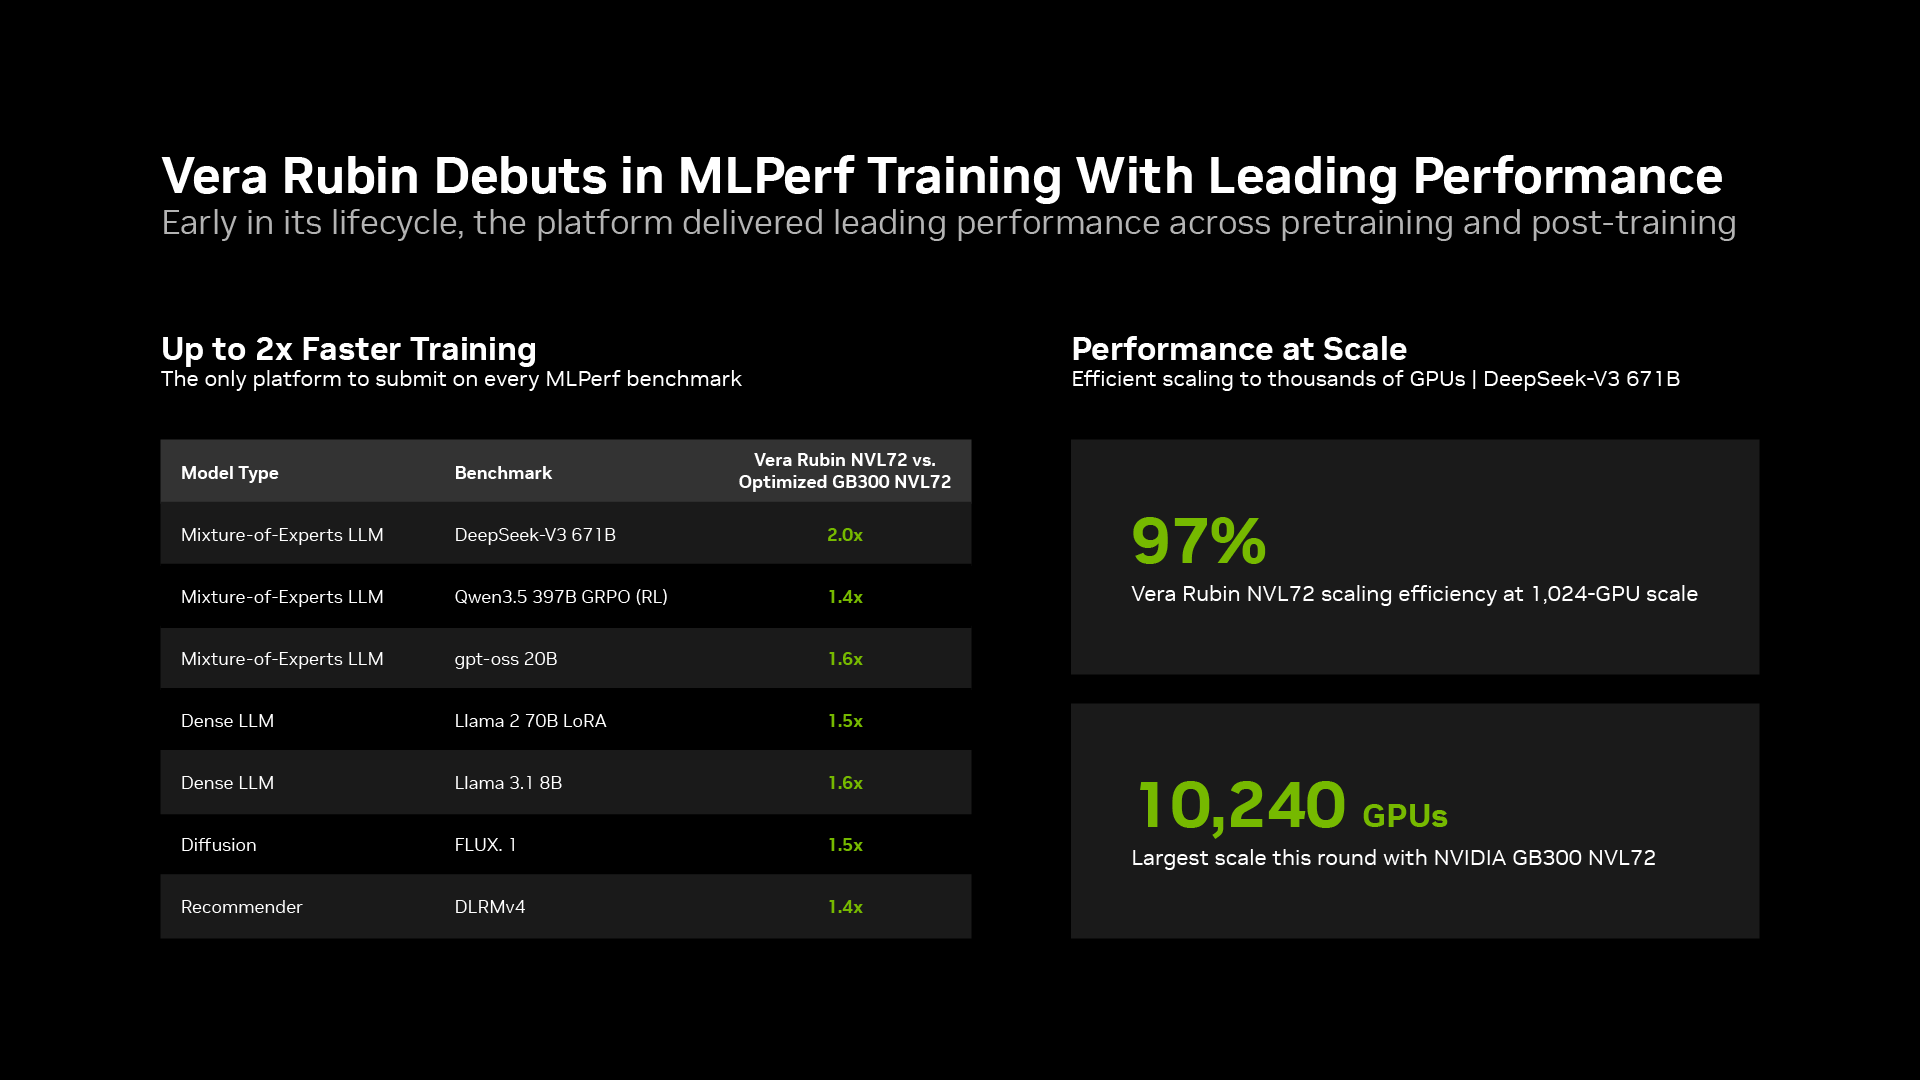
NVIDIA on saavuttanut murskaavan voiton Vera Rubin -alustallaan uusimmissa MLPerf-vertailutuloksissa, merkitsemällä vahvaa ensiesiintymistä sekä koulutus- että päättelysuorituskykymittareissa. Äskettäin julkaistuissa MLPerf Training v6.1 -vertailuissa NVIDIAn Vera Rubin -järjestelmä oli ainoa alusta, joka toimitti tulokset jokaisessa vertailussa kattaen suuret kielimallit, kuvageneraation, suositusjärjestelmät ja vahvistusoppimisen jälkikoulutuksen. Se tarjosi jopa kaksinkertaisen suorituskyvyn per GPU verrattuna erittäin optimoituun NVIDIA GB300 -järjestelmään, osoittaen nopeita sukupolvien välisiä parannuksia laitteistossa ja ohjelmistossa.
Vera Rubin erottui erityisesti skaalaavuudellaan DeepSeek-V3-vertailussa, jossa järjestelmä ylläpiti noin 97 % skaalauskykyä 256:sta 1 024 GPU:hun, lyhentäen koulutusaikaa 16 minuutista noin neljään minuuttiin. NVIDIA myös demonstroi koulutusta valtavassa mittakaavassa: GB300-järjestelmät suorittivat vertailuja käyttäen 10 240 GPU:ta, mikä oli suurin tässä kierroksessa havaittu mittakaava, ja Microsoft Azure vastaavasti GB200-järjestelmillä. Tämä korostaa tehokkaan monen GPU:n koordinoinnin merkitystä, joka saavutettiin NVIDIAn NVLink-skalausverkon avulla järjestelmien sisällä sekä Quantum-X800 InfiniBand ja Spectrum-X Ethernet -skalausverkoilla datakeskusten välillä.
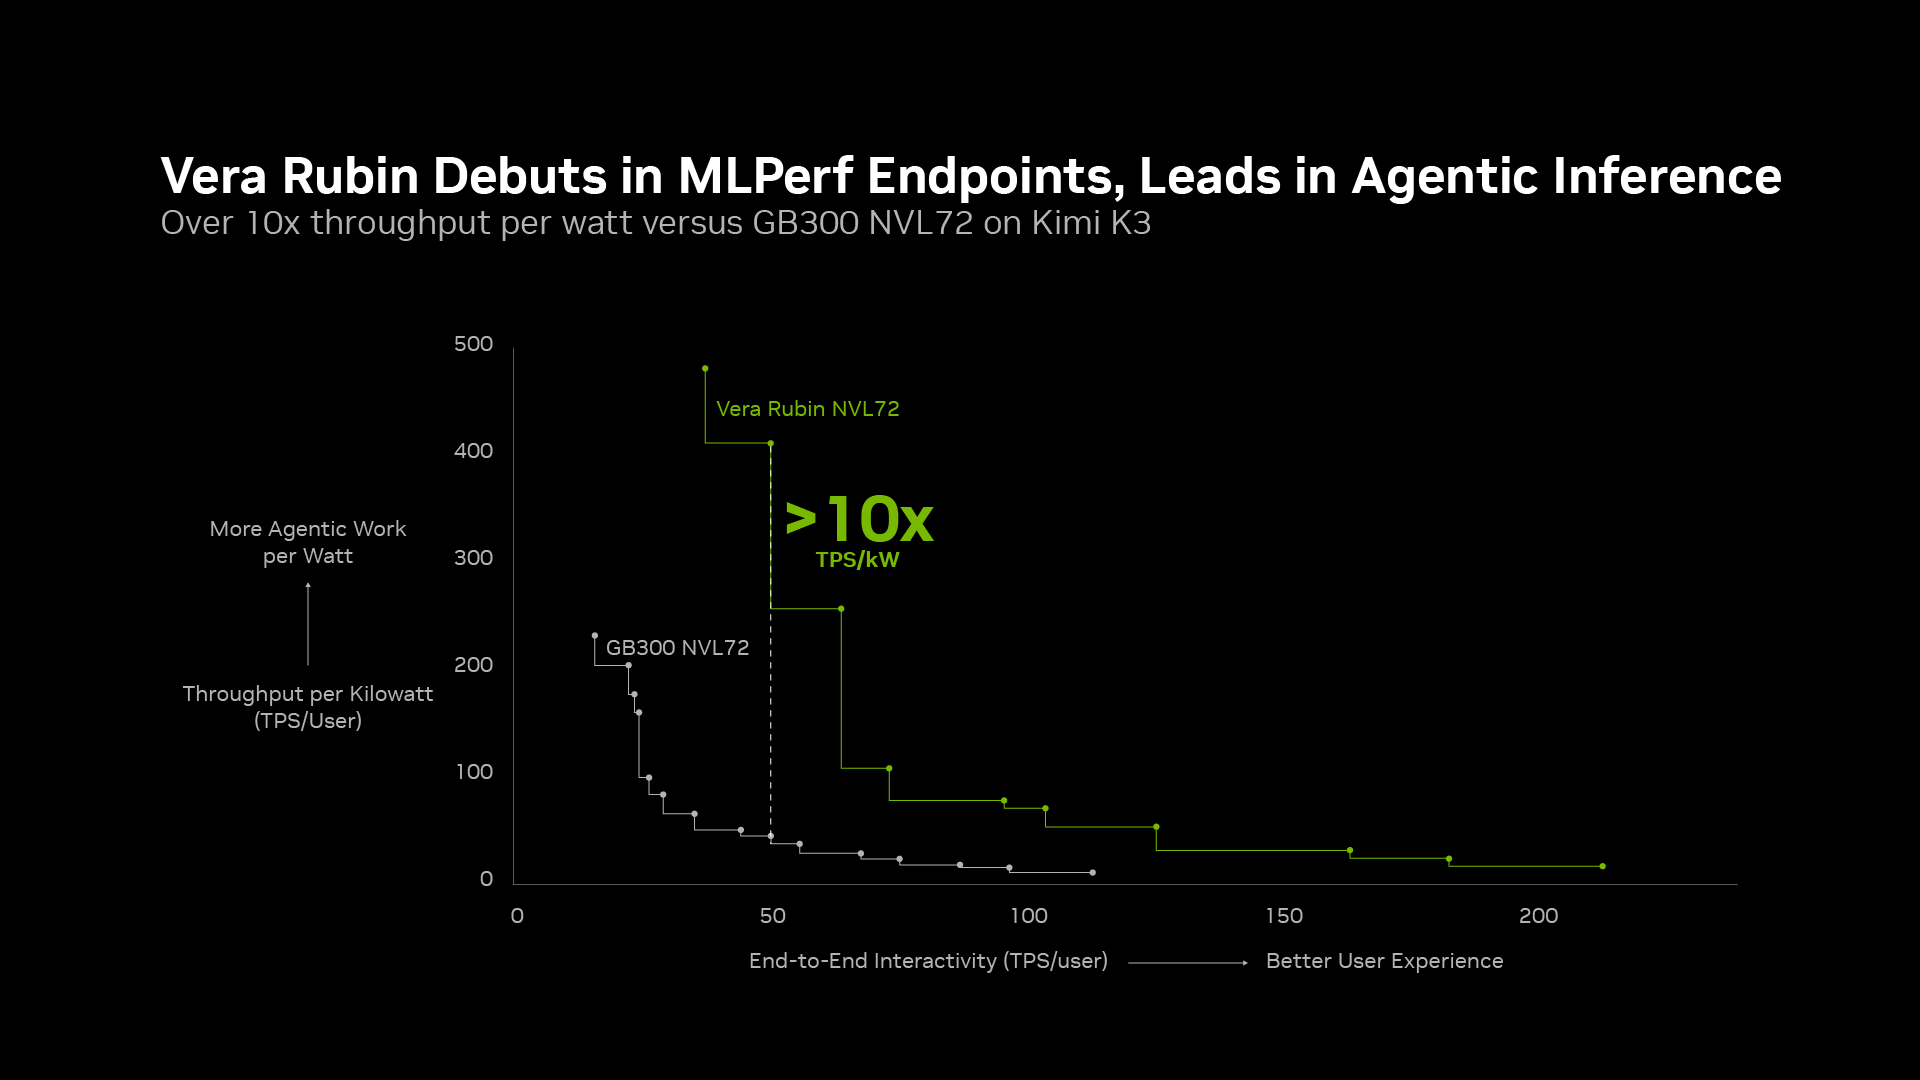
Ensimmäistä kertaa NVIDIA MLPerf Endpointsissa, joka kohdistuu agenttipohjaisiin tekoälyn päättelykuormituksiin, Vera Rubin -alustat saavuttivat yli kymmenkertaisen parannuksen läpimenossa wattia kohti aiempiin sukupolven järjestelmiin, kuten GB300:een, verrattuna samalla kun vastausaika säilyi. Tämä on ratkaisevan tärkeää, koska agenttipohjaiset tekoälytehtävät usein vaativat monivaiheista päättelyä ja toistuvia työkalukutsuja, tuottaen monia tokeneita kutakin suoritettua toimintoa kohden. Korkeampi tokenien tuotanto wattia kohti tarkoittaa, että datakeskukset voivat palvella useampia tekoälyagentteja samanaikaisesti alhaisemmilla energiakustannuksilla.
NVIDIAn kumppaniekosysteemi oli keskeisessä roolissa näissä saavutuksissa, tuloksia toimitti 20 organisaatiota, mukaan lukien Asus, Cisco, Dell Technologies, Google Cloud, HPE, Oracle, Supermicro ja muita. Nämä panokset heijastavat NVIDIAn CUDA-pohjaisen ohjelmistokokonaisuuden monipuolisuutta ja optimointipotentiaalia yhdessä uusimman laitteistoarkkitehtuurin kanssa.
MLPerfin lisäksi Vera Rubin johtaa myös itsenäisissä tekoälyagenttien vertailuissa, kuten SemiAnalysis AgentX:ssä ja Artificial Analysis AgentPerfissä, vahvistaen kykynsä esikoulutuksessa, jälkikoulutuksessa ja agenttipohjaisessa päättelyssä. Se tukee myös korkeaa suorituskykyä vaativia laskennallisia tarpeita, kuten viimeaikaisessa SC26-konferenssissa esiteltiin. NVIDIA ilmoittaa, että jatkuvat ohjelmiston optimoinnit parantavat entisestään Vera Rubinin suorituskykyä, lupaamalla jatkuvaa lisäarvoa tälle infrastruktuurille investoiville asiakkaille.
Yksityiskohtaisia teknisiä näkemyksiä löytyy NVIDIAn MLPerf Training ja MLPerf Endpoints -blogeista, joissa tarjotaan kattava analyysi vertailutuloksista ja järjestelmäkonfiguraatioista. Vera Rubin -alusta vahvistaa NVIDIA:n johtajuuden tekoälyn koulutuksen ja päättelyn kiihdyttämisessä mittakaavassa, yhdistäen tehoefektiivisyyden vertaansa vailla olevaan läpimenoon ja skaalautuvuuteen.
Lähteet ja alkuperäiset raportit
Lue alkuperäinen lähde ↗
Kommentit (0)
Ei vielä kommentteja. Aloita keskustelu.
Kirjoita kommentti
Kommentit julkaistaan moderoinnin jälkeen. Nimesi ja kommenttisi näkyvät julkisesti. Tili