
NVIDIA Vera Rubin-plattform dominerar MLPerf Training och Endpoints benchmark
Bild: NVIDIA · Källa
NVIDIAs nya Vera Rubin-plattform leder MLPerf Training v6.1 benchmark inom alla kategorier och levererar över 10 gånger effektivare agentisk AI-genomströmning per watt i MLPerf Endpoints.
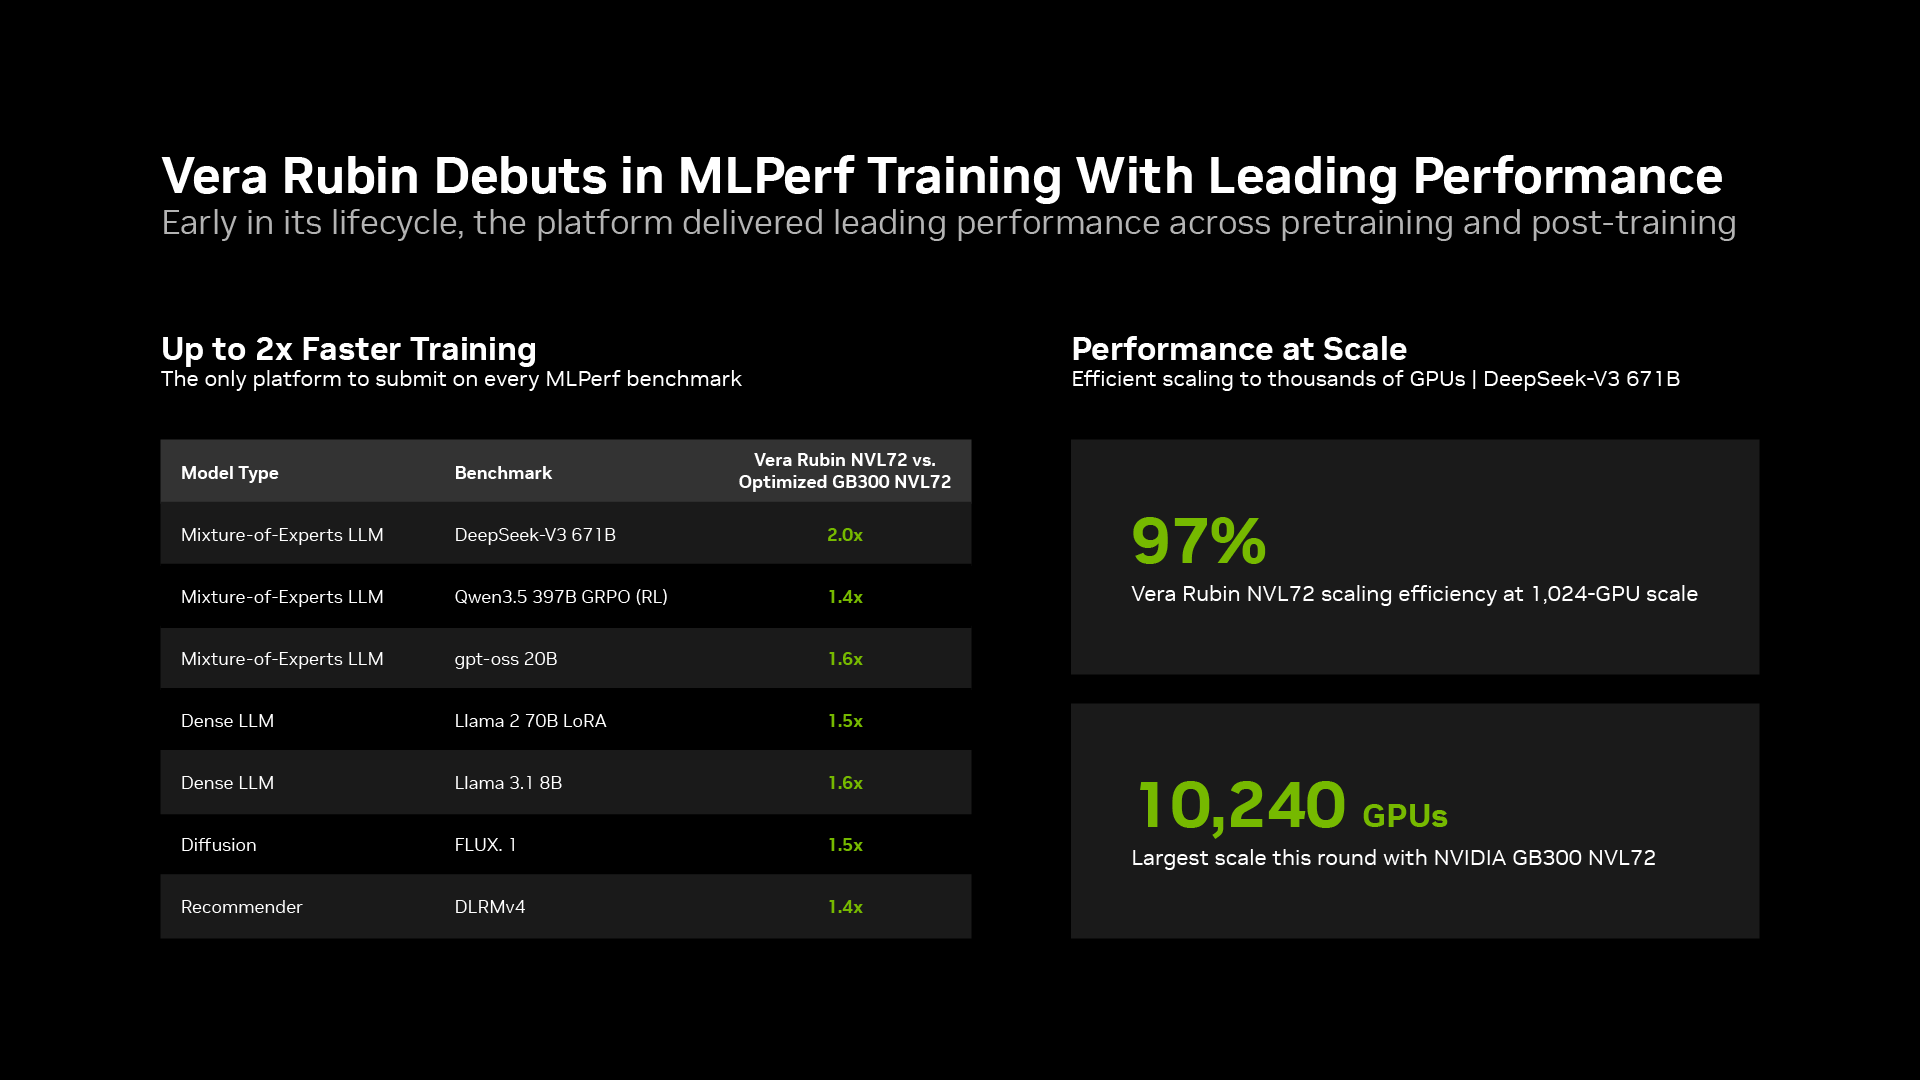
NVIDIA har uppnått en överväldigande seger med sin Vera Rubin-plattform i de senaste MLPerf-benchmarkresultaten, vilket markerar en stark debut både inom träning och inferensprestanda. I de nyligen publicerade MLPerf Training v6.1-benchmarkerna var NVIDIAs Vera Rubin-system den enda plattformen som lämnade in resultat för samtliga benchmark, som täcker stora språkmodeller, bildgenerering, rekommendationssystem och efterträning inom förstärkningsinlärning. Det levererade upp till dubbla prestandan per GPU jämfört med det högoptimerade NVIDIA GB300-systemet, vilket understryker snabba generationsframsteg i deras hårdvara och mjukvara.
Skalbarhet var en höjdpunkt för Vera Rubin, särskilt i DeepSeek-V3-benchmarken, där systemet upprätthöll cirka 97 % skalningseffektivitet från 256 upp till 1 024 GPU:er, vilket reducerade träningstiden från 16 minuter till ungefär fyra minuter. NVIDIA demonstrerade även träning i massiv skala: GB300-systemen körde benchmark med 10 240 GPU:er, den största skala som observerats denna runda, vilket matchades av Microsoft Azure med GB200-system. Detta understryker vikten av effektiv samordning mellan flera GPU:er, möjliggjord genom NVIDIAs NVLink scale-up nätverk inom systemen och Quantum-X800 InfiniBand samt Spectrum-X Ethernet scale-out nätverk över datacenter.
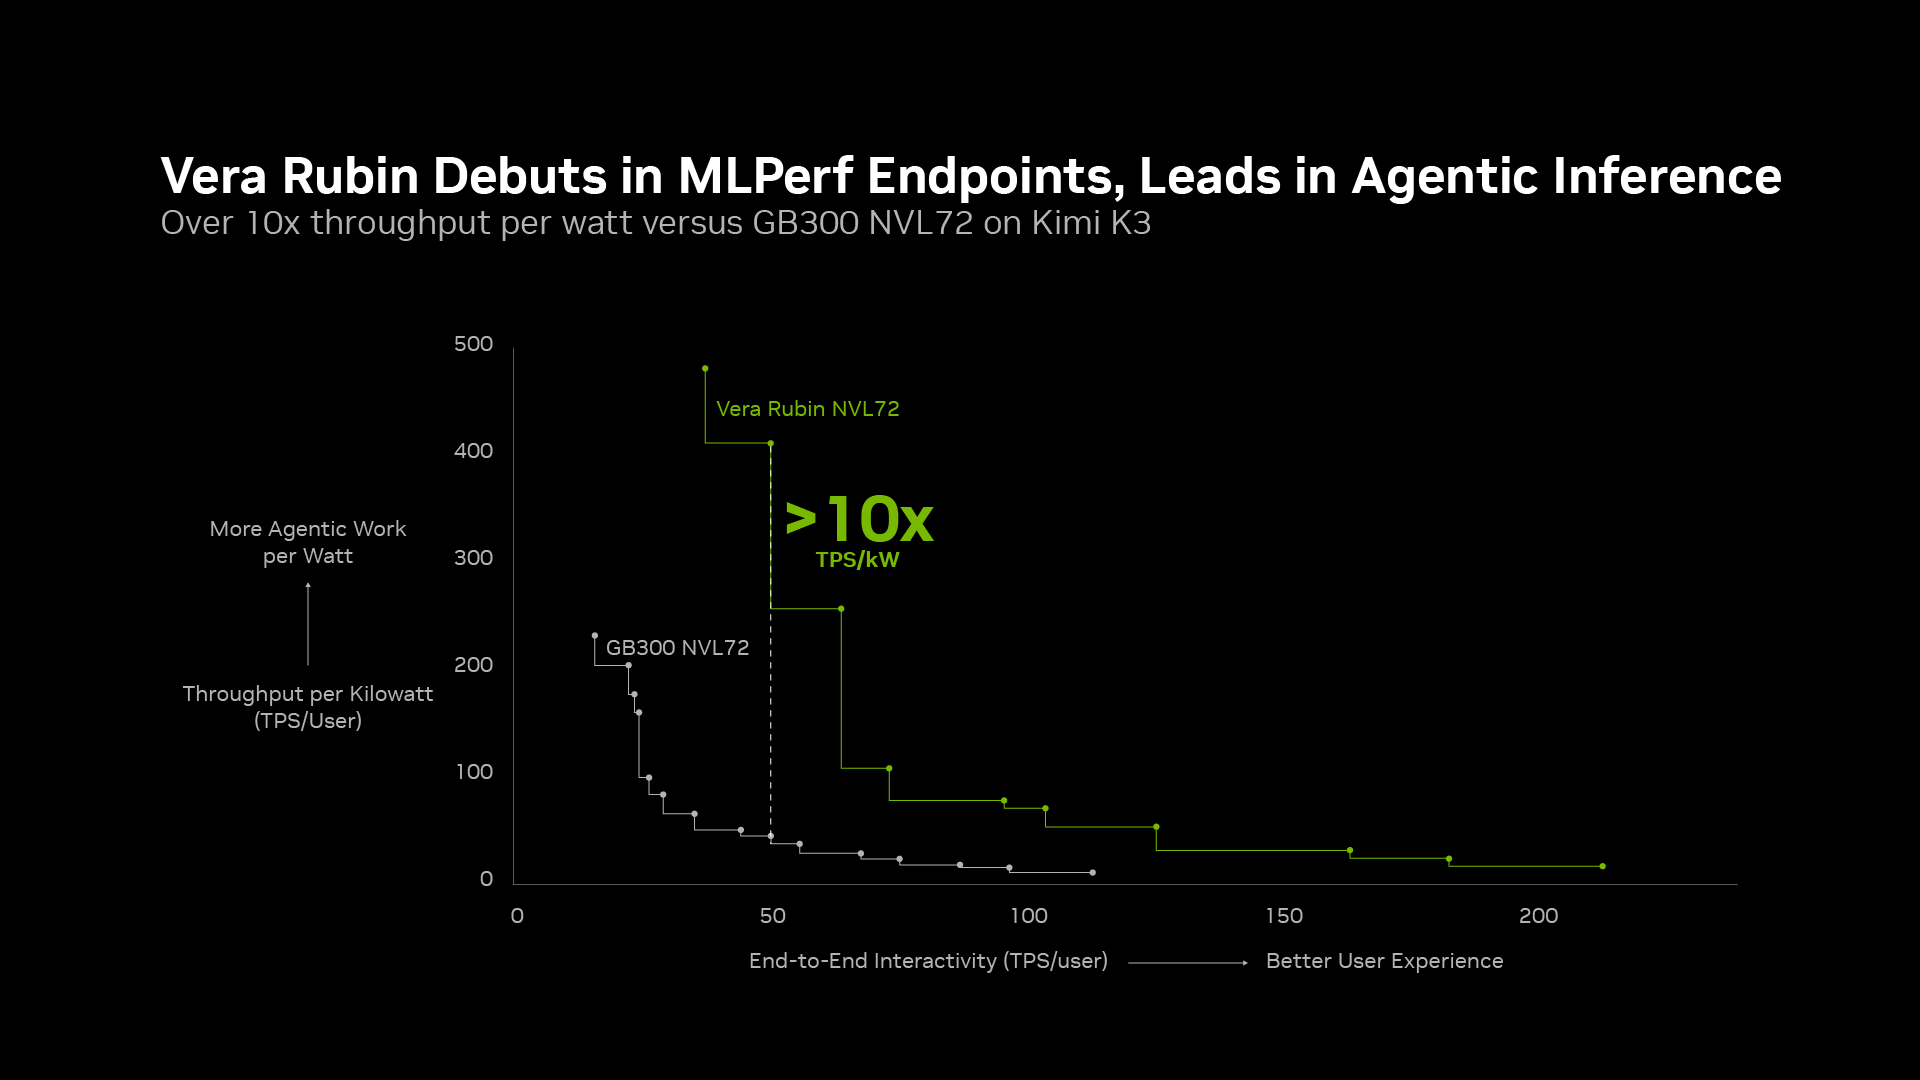
För första gången för NVIDIA i MLPerf Endpoints, som riktar sig mot agentisk AI-inferens, levererade Vera Rubin-plattformarna mer än tiofalt förbättrad genomströmning per watt jämfört med föregående generations system som GB300, samtidigt som svarslatensen bibehölls. Detta är avgörande eftersom agentiska AI-uppgifter ofta kräver flerstegsresonemang och upprepade verktygsanrop, vilket genererar många tokens för varje utförd handling. Högre tokenproduktion per watt innebär att datacenter kan serva fler AI-agenter samtidigt med lägre elkostnader.
NVIDIAs partner-ekosystem spelade en nyckelroll i dessa framgångar, med inlämningar från 20 organisationer inklusive Asus, Cisco, Dell Technologies, Google Cloud, HPE, Oracle, Supermicro och andra. Dessa bidrag speglar mångsidigheten och optimeringspotentialen i NVIDIAs CUDA-drivna mjukvarustack kombinerad med den senaste hårdvaruarkitekturen.
Utöver MLPerf leder Vera Rubin också i oberoende AI-agentbenchmark såsom SemiAnalysis AgentX och Artificial Analysis AgentPerf, vilket bekräftar dess kapacitet över förtränings-, efterträning- och agentisk inferensbelastning. Den stödjer även högpresterande datorkrav, vilket visades vid den senaste SC26-konferensen. NVIDIA anger att pågående mjukvaruoptimeringar ytterligare kommer att förbättra Vera Rubins prestanda och lovar kontinuerlig värdeökning för kunder som investerar i denna infrastruktur.
För detaljerad teknisk insikt erbjuder NVIDIAs MLPerf Training- och MLPerf Endpoints-bloggar en omfattande analys av benchmarkresultaten och de underliggande systemkonfigurationerna. Vera Rubin-plattformen befäster NVIDIAs ledarskap inom acceleration av AI-träning och inferens i stor skala, genom att kombinera energieffektivitet med oöverträffad genomströmning och skalbarhet.
Källor och ursprunglig rapportering
Läs den ursprungliga källan ↗
Kommentarer (0)
Inga kommentarer ännu. Börja diskussionen.
Skriv en kommentar
Kommentarer publiceras efter granskning. Ditt namn och kommentar syns offentligt. Konto