
Google Cloud enthüllt fortschrittliche KI-Trainingsbenchmarks mit TPUs Ironwood der siebten Generation
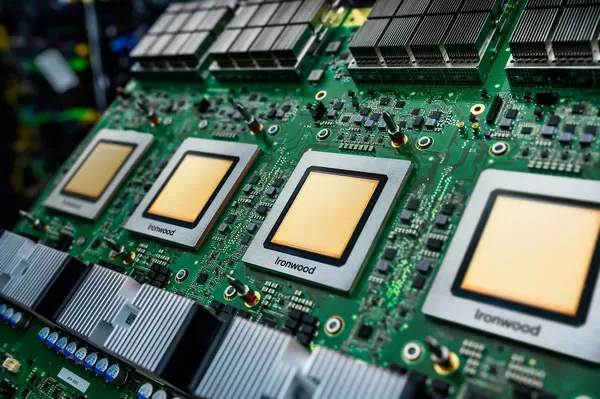
Image: Google · Source
Google Cloud präsentiert neue MLPerf Training v6.1 Ergebnisse mit TPUs Ironwood der siebten Generation und NVIDIA Grace Blackwell GPUs und zeigt führende KI-Trainingsgeschwindigkeiten und Effizienz bei führenden Vortrainings- und agentenbasierten Verstärkungslern-Benchmarks.
Google Cloud hat neue Leistungsbenchmarks für das KI-Training im Rahmen der MLPerf Training v6.1 Runde veröffentlicht und dabei erhebliche Fortschritte mit seinen Tensor Processing Units (TPUs) Ironwood der siebten Generation sowie NVIDIA Grace Blackwell GPUs hervorgehoben. Diese Ergebnisse demonstrieren Googles fortgesetzte Investition in gemeinsam entwickelte Siliziumtechnologie, Netzwerklösungen und offene Softwareinfrastruktur innerhalb seiner AI Hypercomputer-Architektur.
Zu den wichtigsten Errungenschaften gehört, dass 8.192 Ironwood TPUs das Vortraining eines bedeutenden Modells des maschinellen Lernens in nur 1,70 Minuten abschlossen und dabei effizient bis zu 4.096 Chips mit anhaltender 96%-Effizienz skalierten. Diese schnelle Trainingszeit stellt einen bedeutenden Meilenstein bei der Verkürzung der KI-Entwicklungszyklen für groß angelegte Modelle dar.
Darüber hinaus zeigte die Ironwood-Architektur ihre Fähigkeiten bei einem neuen agentenbasierten Verstärkungslern-Benchmark (RL) – dem ersten MLPerf-Wettbewerb dieser Art. Mit 640 Ironwood TPUs erreichte das System die Zielgenauigkeit beim agentenbasierten RL-Codieren in 18,02 Minuten und übertraf dabei die Benchmark-Zielpunktzahl von 0,69 mit einem Ergebnis von 0,765. Die Trainingskonfiguration optimierte zudem die Chipauslastung und sorgte dafür, dass die Hardware während gleichzeitiger Codegenerierungs- und Lernaufgaben weniger als 3 % der Zeit untätig war.
Neben den TPUs reichte Google Cloud auch Ergebnisse mit NVIDIA Grace Blackwell GPUs auf seinen A4X Max Instances ein. Ein Cluster aus 256 NVIDIA GB300 GPUs absolvierte den Vortrainingsbenchmark in 31,96 Minuten, wobei weitere Einsendungen auf den agentenbasierten RL-Benchmark abzielten.
Diese Benchmarks spiegeln die Synergie zwischen Googles maßgeschneiderter Hardware- und Software-Architektur wider und verschieben die Grenzen von KI-Trainingsgeschwindigkeit und Effizienz. Die detaillierten Ergebnisse unterstreichen die Vorteile einer eng integrierten Cloud-AI-Infrastruktur, die speziell auf große und komplexe Modell-Workloads zugeschnitten ist.
Für vollständige technische Details und weitere Ergebnisse der MLPerf Training v6.1 Runde bietet der offizielle Blog von Google Cloud umfassende Informationen.
Quellen und Originalberichte
Read the original source ↗
Kommentare (0)
Noch keine Kommentare.
Kommentar schreiben
Kommentare erscheinen nach Moderation. Name und Kommentar werden öffentlich angezeigt. Konto