
Tenstorrent Galaxy oppnår 5 300 tokens per sekund dekoderingshastighet på OpenAI sin gpt-oss-120b-modell
Bilde: Tenstorrent · Kilde
Tenstorrents Galaxy-system kjører OpenAI sin gpt-oss-120b med opptil 5 300 tokens per sekund per bruker ved å bruke åtte sammenkoblede Galaxy-klynger, og utnytter en Mixture-of-Experts-arkitektur og effektiv maskinvareutforming.
Tenstorrent har demonstrert bransjeledende ytelse ved å kjøre OpenAI sin open-weight språkmodell, gpt-oss-120b, og oppnå dekoderingshastigheter på opptil 5 300 tokens per sekund per bruker på en klynge bestående av åtte Galaxy-systemer. Denne ytelsen representerer et betydelig fremskritt innen effektiv inferens av store modeller for responsive AI-applikasjoner.
Gpt-oss-120b-modellen bruker en Mixture-of-Experts (MoE) arkitektur, hvor hver token rutes gjennom kun 4 av 128 ekspertkomponenter i stedet for å aktivere hele modellen. Denne selektive aktiveringen gjør at modellen bruker omtrent 5,1 milliarder av sine 117 milliarder parametere per token, noe som forbedrer beregningseffektiviteten uten å gå på kompromiss med nøyaktigheten.
Tenstorrents Galaxy-system integrerer 32 Blackhole-brikker i en kompakt 6U-server, utstyrt med 6,2 GB høy-båndbredde on-chip SRAM og 1 TB GDDR6 DRAM. Arkitekturen prioriterer å holde data nær beregningsenhetene for å redusere latenstid, ved å bruke SRAM til lagring av kritiske ekspertvekter og strømme resten fra DRAM. Galaxy-systemer kobles sammen over standard Ethernet, noe som muliggjør fleksibel skalering fra en enkelt server til multi-maskinklynger.
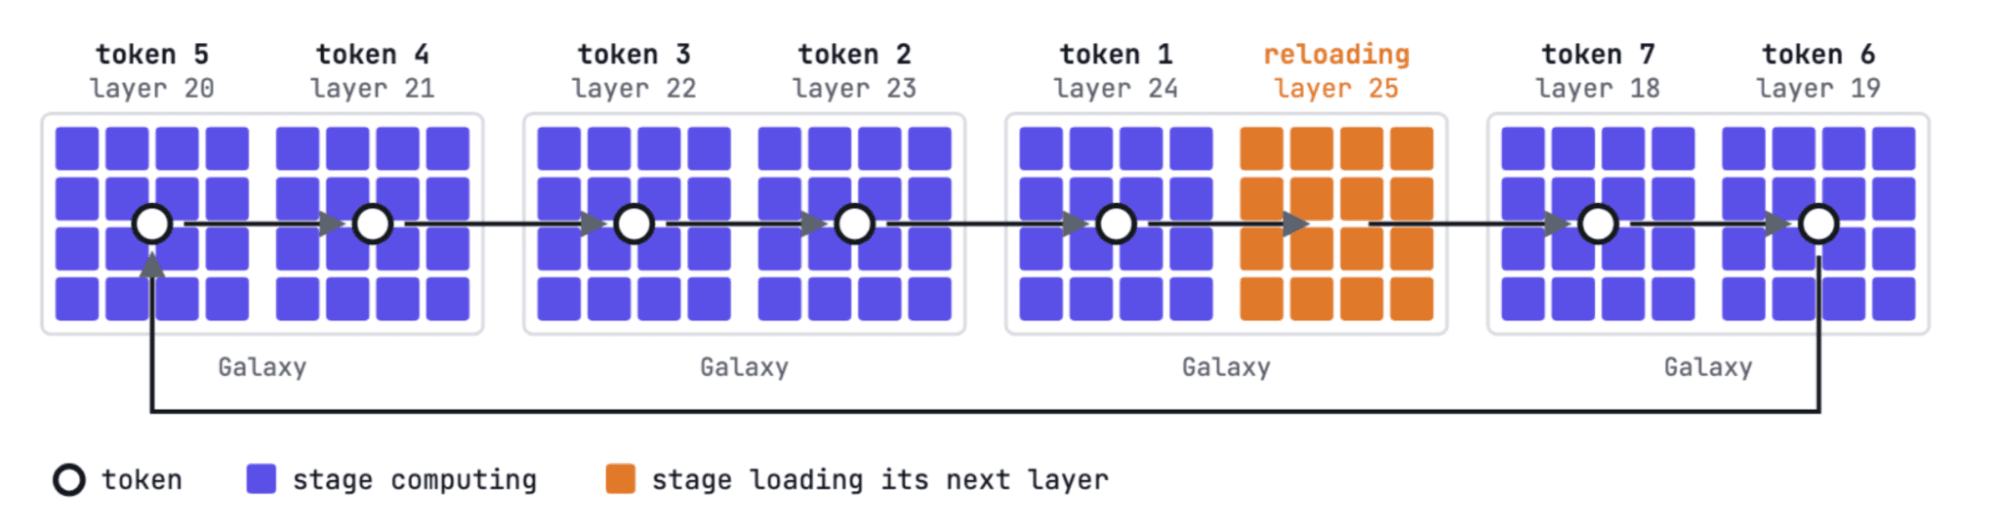
Distribusjonsarkitekturen deler hvert modellag over et 4×4 nettverk av 16 Blackhole-brikker. Systemet gjenbruker pipeline-stadier—mens ett trinn behandler det nåværende laget, lastes neste lags vekter inn i SRAM—noe som maksimerer maskinvareutnyttelsen. Brikkene overfører aktiveringer mellom stadier via direkte, lav-latens Ethernet-lenker arrangert for å speile fysisk kabling, noe som muliggjør effektiv distribuert beregning over flere maskiner.
Testing på GSM8K-datasettet, som består av omtrent 8 500 mattestykker på grunnskolenivå som krever trinnvis resonnement, oppnådde Galaxy i gjennomsnitt 3 000 tokens per sekund per bruker med en nøyaktighet på 95,8 %. Toppfartene nådde 5 300 tokens per sekund per bruker, fokusert på dekoderingsoperasjoner med korte prompts, ekskludert initial latenstid for token-generering.
Denne demonstrasjonen fremhever Tenstorrents evne til å levere rask, nøyaktig og skalerbar inferens for store MoE-modeller på åpen maskinvare. Organisasjoner som planlegger distribusjoner som krever lav-latens AI-inferens kan evaluere Galaxys kapasiteter for å balansere ytelse, skalerbarhet og kostnad. Den modulære naturen til Galaxy støtter gradvis skalering fra enkelt-enheter til omfattende multi-node klynger.
Tenstorrent fortsetter å innovere innen effektiv AI-acceleratordesign, med vekt på strømlinjeformet databevegelse og balanse mellom minnekapasitet og beregningsnærhet. Interessenter kan kontakte Tenstorrent for mer informasjon eller utforske Galaxy for sine AI-inferens infrastrukturelle behov.

Kilder og originalrapportering
Les originalkilden ↗
Kommentarer (0)
Ingen kommentarer ennå. Start diskusjonen.
Skriv en kommentar
Kommentarer publiseres etter moderering. Ditt navn og kommentar vil være synlige offentlig. Konto