
Tenstorrent Galaxy saavutab OpenAI gpt-oss-120b mudelil 5 300 märki sekundis dekodeerimise kiiruse
Pilt: Tenstorrent · Allikas
Tenstorrenti Galaxy süsteem töötab OpenAI gpt-oss-120b mudeliga kuni 5 300 märki sekundis kasutaja kohta kaheksa ühendatud Galaxy klastriga, kasutades Mixture-of-Experts arhitektuuri ja tõhusat riistvaralahendust.
Tenstorrent on demonstreerinud tööstusharu tipptasemel jõudlust, käivitades OpenAI avatud kaaludega keelemudeli gpt-oss-120b, saavutades kaheksa Galaxy süsteemist koosneval klastril dekodeerimiskiiruse kuni 5 300 märki sekundis kasutaja kohta. See tulemus tähistab olulist edenemist tõhusas suure mudeli järelduste tegemises reaalajas AI rakenduste jaoks.
Gpt-oss-120b mudel kasutab Mixture-of-Experts (MoE) arhitektuuri, kus iga märk suunatakse läbi vaid 4 eksperdirakenduse 128st, mitte kogu mudeli aktiveerimisele. See selektiivne aktiveerimine võimaldab mudelil kasutada iga märgi kohta ligikaudu 5,1 miljardit oma 117 miljardi parameetri hulgast, suurendades arvutuslikku tõhusust ilma täpsust ohverdamata.
Tenstorrenti Galaxy süsteem integreerib 32 Blackhole kiipi kompaktses 6U serveris, mis on varustatud 6,2 GB kõrge läbilaskevõimega sisemise SRAM-iga ja 1 TB GDDR6 DRAM-iga. Arhitektuur panustab andmete hoidmisele arvutusüksuste lähedal, et vähendada latentsust, kasutades SRAM-i kriitiliste ekspertkaalude salvestamiseks ja ülejäänut voogedastuseks DRAM-ist. Galaxy süsteemid on omavahel ühendatud standardse Etherneti kaudu, võimaldades paindlikku laiendamist ühest serverist kuni mitme masina klastriteni.
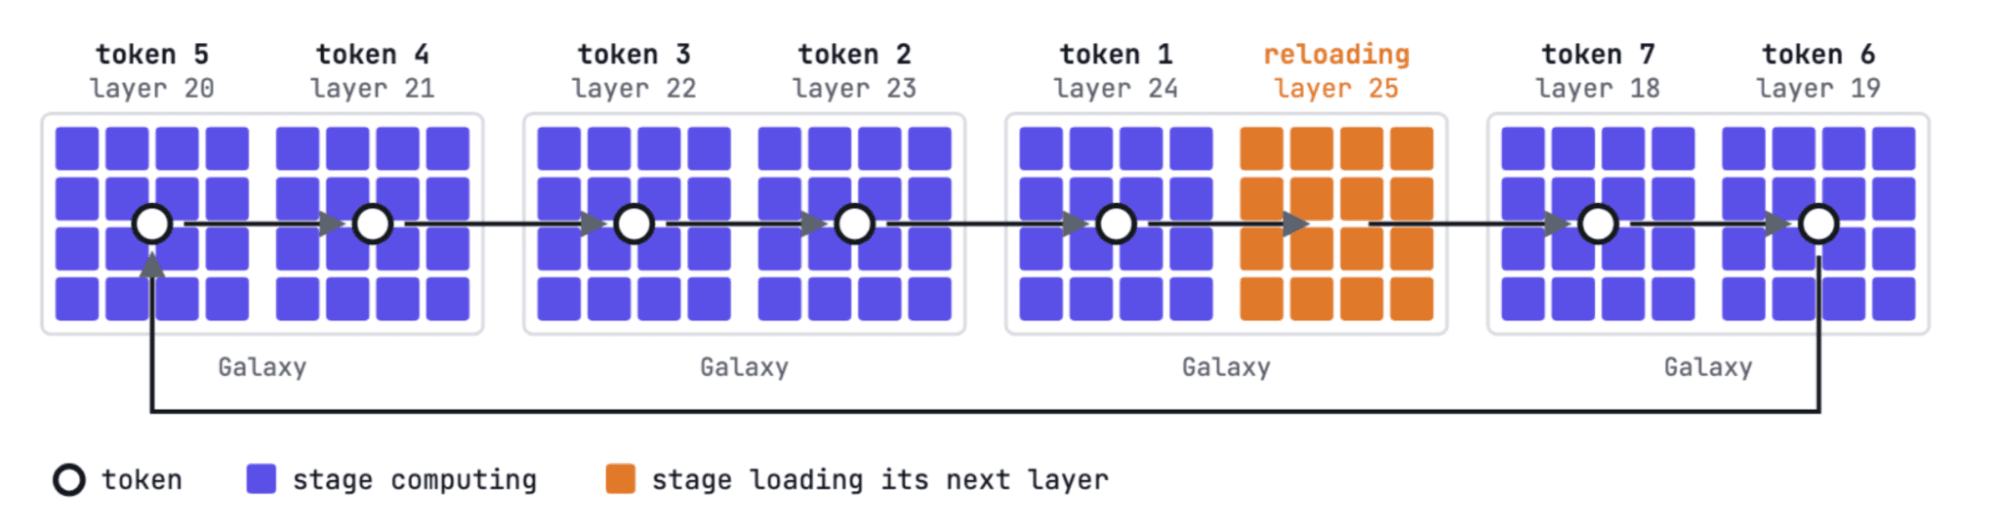
Paigaldus arhitektuur jagab iga mudeli kihi 4×4 võrgustikuks 16 Blackhole kiibi vahel. Süsteem kasutab torujuhtme etappide taaskasutust – kui üks etapp töötleb käesolevat kihti, laaditakse järgmise kihi kaalud SRAM-i –, maksimeerides riistvara kasutust. Kiibid edastavad aktivatsioone etappide vahel läbi otseste madala latentsusega Etherneti linkide, mis on seadistatud füüsilist kaablit peegeldavalt, võimaldades tõhusat hajutatud arvutust mitme masina vahel.
GSM8K andmekogumil, mis sisaldab umbes 8 500 põhikooli matemaatika sõnaprobleemi, mis nõuavad samm-sammulist põhjendamist, saavutas Galaxy keskmiselt 3 000 märki sekundis kasutaja kohta 95,8% täpsusega. Tihenud maksimaalsed kiirused ulatusid 5 300 märgini sekundis kasutaja kohta, keskendudes dekodeerimistoimingutele lühikeste käsklustega, välistades esimese märgi genereerimise hilinemise.
See näide rõhutab Tenstorrenti võimekust pakkuda kiiret, täpset ja skaleeritavat järeldust töötlemaks suuri MoE mudeleid avatud riistvaral. Organisatsioonid, kes planeerivad madala latentsusega AI järeldust vajavaid paigaldusi, võivad hinnata Galaxy võimeid jõudluse, skaleeritavuse ja kulude tasakaalustamiseks. Galaxy moodulaarne loomus toetab järkjärgulist laienemist alates üksikutest seadmetest kuni laiate multi-sõlme klastriteni.
Tenstorrent jätkab innovatsiooni tõhusate AI kiirendajate kujundamisel, rõhutades optimeeritud andmeliigutusi ja mälumahtude ja arvutusläheduse tasakaalu. Huvi korral saab Tenstorrentiga ühendust võtta täpsemate detailide saamiseks või Galaxy kasutamiseks oma AI järelduste infrastruktuuri vajaduste jaoks.

Allikad ja originaaluudised
Loe originaali allikat ↗
Kommentaarid (0)
Kommentaare veel pole. Alusta arutelu.
Kirjuta kommentaar
Kommentaarid avaldatakse pärast modereerimist. Sinu nimi ja kommentaar on avalikult nähtavad. Konto