
Tenstorrent Galaxy osiąga prędkość dekodowania 5 300 tokenów na sekundę na modelu gpt-oss-120b OpenAI
Image: Tenstorrent · Source
System Galaxy firmy Tenstorrent uruchamia model gpt-oss-120b OpenAI z prędkością do 5 300 tokenów na sekundę na użytkownika, korzystając z ośmiu połączonych klastrów Galaxy i wykorzystując architekturę Mixture-of-Experts oraz efektywny projekt sprzętowy.
Tenstorrent zaprezentował wydajność na poziomie wiodącym w branży, uruchamiając model językowy OpenAI z otwartą wagą, gpt-oss-120b, osiągając prędkości dekodowania do 5 300 tokenów na sekundę na użytkownika na klastrze ośmiu systemów Galaxy. Ten wynik stanowi znaczący postęp w efektywnym wnioskowaniu dużych modeli dla responsywnych aplikacji AI.
Model gpt-oss-120b wykorzystuje architekturę Mixture-of-Experts (MoE), gdzie każdy token jest kierowany tylko przez 4 z 128 komponentów ekspertów, zamiast aktywować cały model. Ta selektywna aktywacja umożliwia modelowi użycie około 5,1 miliarda z jego 117 miliardów parametrów na token, zwiększając efektywność obliczeniową bez utraty dokładności.
System Galaxy firmy Tenstorrent integruje 32 układy Blackhole w kompaktowym serwerze 6U, wyposażonym w 6,2 GB pamięci SRAM o wysokim przepustowości na chipie oraz 1 TB pamięci GDDR6 DRAM. Architektura priorytetyzuje przechowywanie danych blisko jednostek obliczeniowych, aby zmniejszyć latencję, wykorzystując SRAM do krytycznego przechowywania wag ekspertów i przesyłając resztę z DRAM. Systemy Galaxy łączą się przez standardowy Ethernet, umożliwiając elastyczne skalowanie od pojedynczego serwera do klastrów wielomaszynowych.
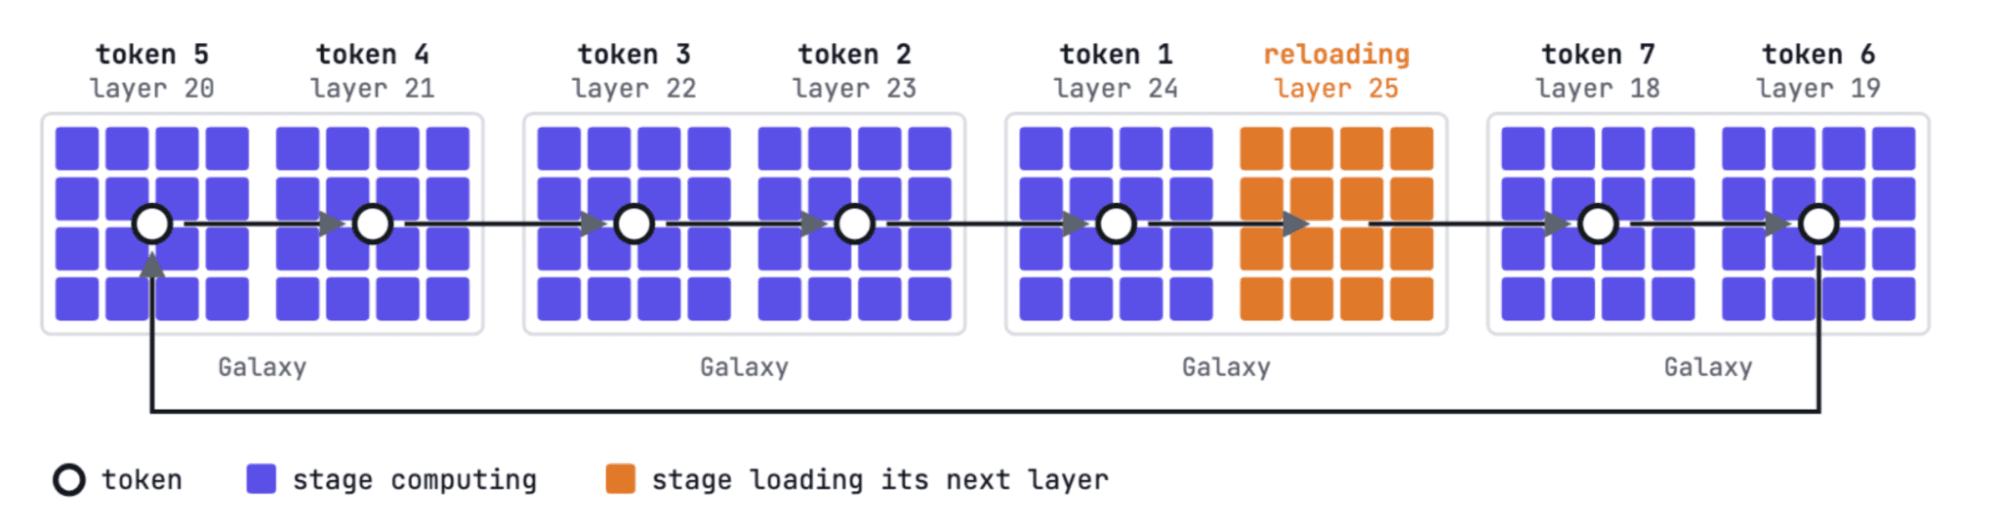
Architektura wdrożeniowa dzieli każdą warstwę modelu na siatkę 4×4 złożoną z 16 układów Blackhole. System ponownie wykorzystuje etapy potoku – podczas gdy jeden etap przetwarza bieżącą warstwę, wagi następnej warstwy ładują się do SRAM – maksymalizując wykorzystanie sprzętu. Układy przekazują aktywacje między etapami poprzez bezpośrednie, niskolatencyjne połączenia Ethernet ułożone tak, aby odzwierciedlać fizyczne okablowanie, umożliwiając efektywne rozproszone obliczenia na wielu maszynach.
Testy na zestawie danych GSM8K, składającym się z około 8 500 problemów matematycznych na poziomie szkoły podstawowej wymagających rozumowania krok po kroku, wykazały średnią 3 000 tokenów na sekundę na użytkownika przy dokładności 95,8%. Szczytowe prędkości osiągnęły 5 300 tokenów na sekundę na użytkownika, koncentrując się na operacjach dekodowania z krótkimi sugestiami, wykluczając początkową latencję generowania tokenów.
To demonstracja podkreśla zdolność Tenstorrent do dostarczania szybkiego, dokładnego i skalowalnego wnioskowania dla dużych modeli MoE na otwartym sprzęcie. Organizacje planujące wdrożenia wymagające niskolatencyjnego wnioskowania AI mogą ocenić możliwości Galaxy pod kątem równowagi między wydajnością, skalowalnością i kosztami. Modułowa konstrukcja Galaxy wspiera stopniowe skalowanie od pojedynczych jednostek do rozległych klastrów wielowęzłowych.
Tenstorrent kontynuuje innowacje w projektowaniu wydajnych akceleratorów AI, kładąc nacisk na usprawniony ruch danych i równowagę między pojemnością pamięci a bliskością obliczeń. Zainteresowane strony mogą skontaktować się z Tenstorrent, aby uzyskać więcej informacji lub poznać Galaxy w kontekście swoich potrzeb infrastruktury wnioskowania AI.

Źródła i oryginalne doniesienia
Read the original source ↗
Komentarze (0)
Nie ma jeszcze komentarzy.
Napisz komentarz
Komentarze publikujemy po moderacji. Nazwa i komentarz będą publiczne. Konto