
Tenstorrent Galaxy uppnår 5 300 tokens per sekund avkodningshastighet på OpenAI:s gpt-oss-120b-modell
Bild: Tenstorrent · Källa
Tenstorrents Galaxy-system kör OpenAI:s gpt-oss-120b med upp till 5 300 tokens per sekund per användare med åtta sammankopplade Galaxy-kluster, vilket utnyttjar en Mixture-of-Experts-arkitektur och effektiv hårdvarudesign.
Tenstorrent har visat branschledande prestanda genom att köra OpenAI:s open-weight språkmodell, gpt-oss-120b, och uppnå avkodningshastigheter på upp till 5 300 tokens per sekund per användare på ett kluster med åtta Galaxy-system. Denna prestanda representerar ett betydande framsteg inom effektiv inferens för stora modeller i responsiva AI-applikationer.
Gpt-oss-120b-modellen använder en Mixture-of-Experts (MoE)-arkitektur, där varje token dirigeras genom endast 4 av 128 expertkomponenter istället för att aktivera hela modellen. Denna selektiva aktivering gör det möjligt för modellen att använda ungefär 5,1 miljarder av sina 117 miljarder parametrar per token, vilket ökar den beräkningsmässiga effektiviteten utan att offra noggrannheten.
Tenstorrents Galaxy-system integrerar 32 Blackhole-chips i en kompakt 6U-server, utrustad med 6,2 GB högbandbredds on-chip SRAM och 1 TB GDDR6 DRAM. Arkitekturen prioriterar att hålla data nära beräkningsenheterna för att minska latens, genom att använda SRAM för kritisk lagring av expertvikter och strömma resten från DRAM. Galaxy-system kopplas samman via standard Ethernet, vilket möjliggör flexibel skalning från en enda server till multi-maskinkluster.
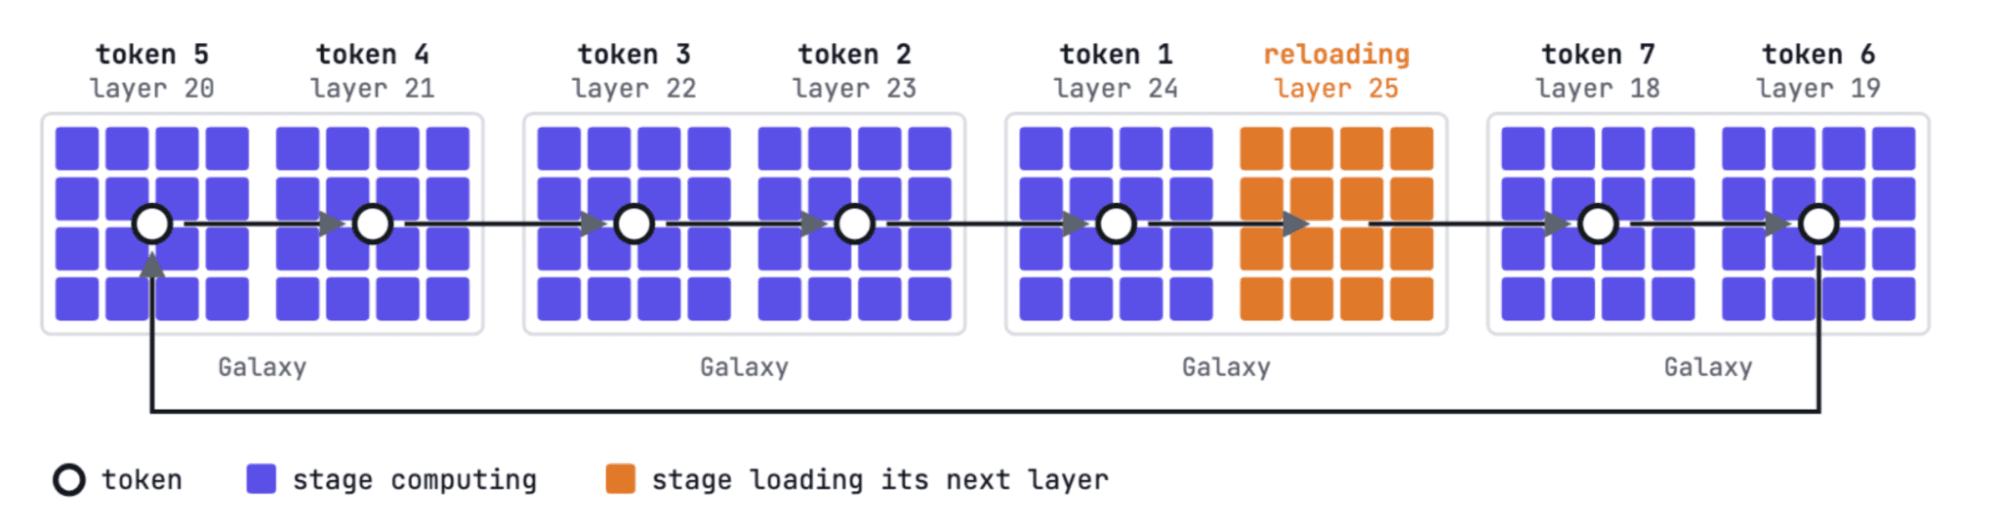
Implementeringsarkitekturen delar varje modellager över ett 4×4-nätverk av 16 Blackhole-chips. Systemet återanvänder pipeline-stadier—medan ett steg bearbetar det aktuella lagret, laddas nästa lagers vikter in i SRAM—vilket maximerar hårdvaruanvändningen. Chips skickar aktiveringar mellan stadier genom direkta, låglatens Ethernet-länkar arrangerade för att spegla fysisk kablage, vilket möjliggör effektiv distribuerad beräkning över flera maskiner.
Testning på GSM8K-datasetet, som består av cirka 8 500 mattetal på grundskolenivå som kräver stegvis resonemang, gav Galaxy i genomsnitt 3 000 tokens per sekund per användare med en noggrannhet på 95,8 %. Topphastigheter nådde 5 300 tokens per sekund per användare, fokuserat på avkodningsoperationer med korta prompts, exklusive initial latens för token-generering.
Denna demonstration lyfter fram Tenstorrents förmåga att leverera snabb, exakt och skalbar inferens för stora MoE-modeller på öppen hårdvara. Organisationer som planerar distributioner som kräver låglatens AI-inferens kan utvärdera Galaxys förmågor för att balansera prestanda, skalbarhet och kostnad. Galaxys modulära natur stödjer gradvis skalning från enkla enhetskonfigurationer till omfattande multi-nod-kluster.
Tenstorrent fortsätter att innovera inom effektiv design av AI-acceleratorer, med fokus på strömlinjeformad datarörelse och balans mellan minneskapacitet och beräkningsnärhet. Intresserade parter kan kontakta Tenstorrent för ytterligare information eller utforska Galaxy för sina AI-inferensinfrastruktursbehov.

Källor och ursprunglig rapportering
Läs den ursprungliga källan ↗
Kommentarer (0)
Inga kommentarer ännu. Börja diskussionen.
Skriv en kommentar
Kommentarer publiceras efter granskning. Ditt namn och kommentar syns offentligt. Konto