
Tenstorrent Galaxy достигает скорости декодирования 5300 токенов в секунду на модели gpt-oss-120b OpenAI
Image: Tenstorrent · Source
Система Galaxy компании Tenstorrent выполняет модель gpt-oss-120b OpenAI со скоростью до 5300 токенов в секунду на пользователя, используя восемь связанных кластеров Galaxy, применяя архитектуру Mixture-of-Experts и эффективный аппаратный дизайн.
Компания Tenstorrent продемонстрировала производительность, лидирующую в отрасли, запустив открытую языковую модель OpenAI gpt-oss-120b, достигнув скорости декодирования до 5300 токенов в секунду на пользователя на кластере из восьми систем Galaxy. Этот результат представляет собой значительный прогресс в эффективном выводе больших моделей для отзывчивых AI-приложений.
Модель gpt-oss-120b использует архитектуру Mixture-of-Experts (MoE), при которой каждый токен проходит только через 4 из 128 экспертных компонентов, а не через всю модель полностью. Этот селективный активационный механизм позволяет модели использовать примерно 5,1 миллиарда из своих 117 миллиардов параметров на один токен, повышая вычислительную эффективность без потери точности.
Система Galaxy от Tenstorrent интегрирует 32 чипа Blackhole в компактном сервере 6U, оснащённом 6,2 ГБ высокопроизводительной SRAM на кристалле и 1 ТБ памяти GDDR6 DRAM. Архитектура ориентирована на хранение данных близко к вычислительным блокам для снижения задержки, используя SRAM для критического хранения весов экспертов и потоковую передачу остального из DRAM. Системы Galaxy соединяются по стандартному Ethernet, что обеспечивает гибкое масштабирование от одного сервера до многомашинных кластеров.
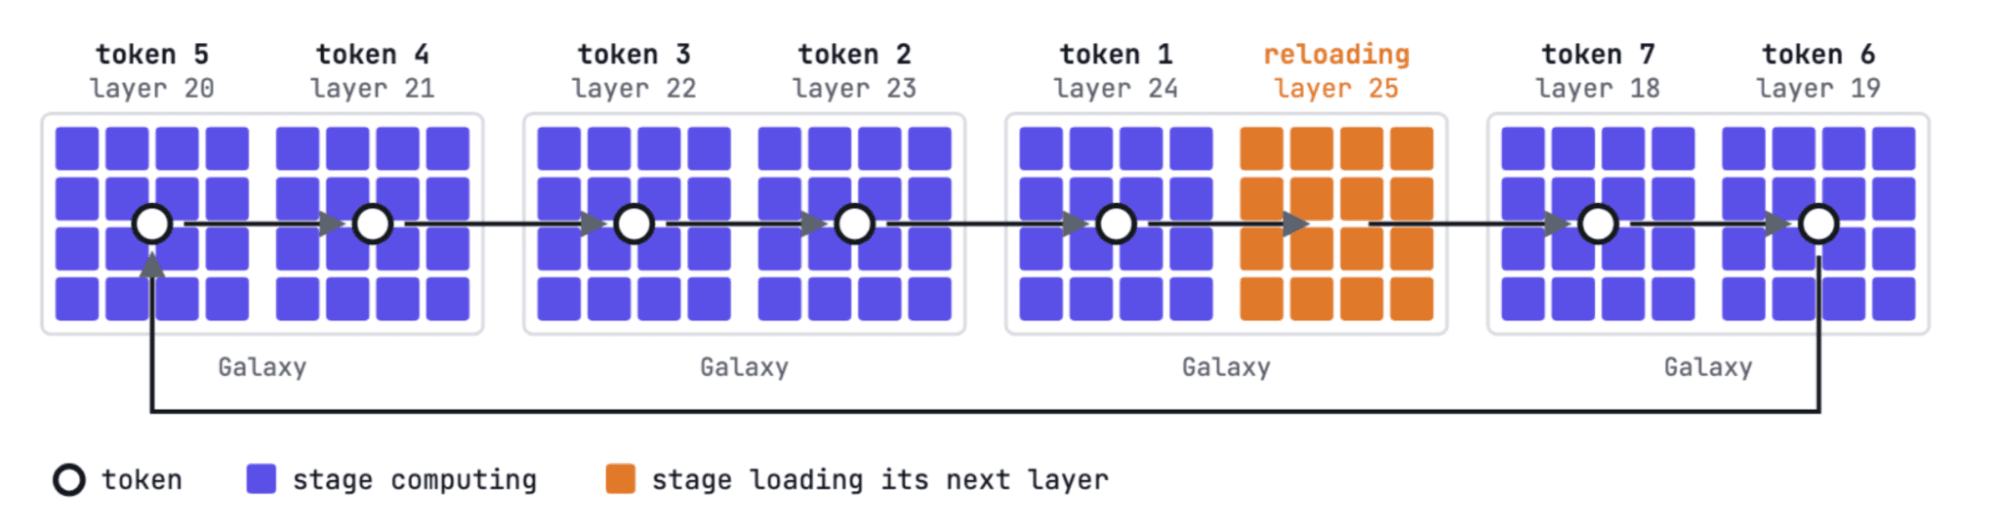
Архитектура развертывания разделяет каждый слой модели по сетке 4×4 из 16 чипов Blackhole. Система повторно использует стадии конвейера — пока одна стадия обрабатывает текущий слой, веса следующего слоя загружаются в SRAM — что максимизирует использование оборудования. Чипы передают активации между стадиями через прямые, низколатентные Ethernet-соединения, организованные зеркально физической укладке кабелей, обеспечивая эффективное распределённое вычисление на нескольких машинах.
Тестирование на наборе данных GSM8K, включающем около 8500 задач по математике начальной школы, требующих поэтапного рассуждения, показало среднюю скорость 3000 токенов в секунду на пользователя при точности 95,8%. Пиковые скорости достигли 5300 токенов в секунду на пользователя, сосредоточившись на операциях декодирования при коротких подсказках, без учёта первоначальной задержки генерации токенов.
Демонстрация подчёркивает способность Tenstorrent обеспечивать быстрое, точное и масштабируемое выполнение вывода больших моделей MoE на открытом аппаратном обеспечении. Организации, планирующие развертывания с требованиями низкой задержки AI-вывода, могут оценить возможности Galaxy с точки зрения баланса производительности, масштабируемости и стоимости. Модульная природа Galaxy поддерживает постепенное масштабирование от единичных систем до крупных многокузловых кластеров.
Tenstorrent продолжает инновации в разработке эффективных ускорителей AI с упором на оптимизированное движение данных и баланс между ёмкостью памяти и близостью вычислений. Заинтересованные стороны могут связаться с Tenstorrent для получения дополнительной информации или ознакомиться с Galaxy в контексте своих потребностей в инфраструктуре AI-вывода.

Источники и первоисточники
Read the original source ↗
Комментарии (0)
Комментариев пока нет. Начните обсуждение.
Написать комментарий
Комментарии публикуются после модерации. Ваше имя и комментарий будут видны всем. Аккаунт