
Tenstorrent Galaxy alcanza una velocidad de decodificación de 5,300 tokens por segundo en el modelo gpt-oss-120b de OpenAI
Image: Tenstorrent · Source
El sistema Galaxy de Tenstorrent ejecuta el gpt-oss-120b de OpenAI a hasta 5,300 tokens por segundo por usuario usando ocho clústeres Galaxy conectados, aprovechando una arquitectura de Mezcla de Expertos y un diseño eficiente de hardware.
Tenstorrent ha demostrado un rendimiento líder en la industria al ejecutar el modelo de lenguaje de peso abierto de OpenAI, gpt-oss-120b, alcanzando velocidades de decodificación de hasta 5,300 tokens por segundo por usuario en un clúster de ocho sistemas Galaxy. Este rendimiento representa un avance significativo en la inferencia eficiente de modelos grandes para aplicaciones de IA responsivas.
El modelo gpt-oss-120b emplea una arquitectura de Mezcla de Expertos (Mixture-of-Experts, MoE), donde cada token es procesado solo por 4 de 128 componentes expertos en lugar de activar todo el modelo. Esta activación selectiva permite que el modelo use aproximadamente 5.1 mil millones de sus 117 mil millones de parámetros por token, mejorando la eficiencia computacional sin sacrificar precisión.
El sistema Galaxy de Tenstorrent integra 32 chips Blackhole en un servidor compacto de 6U, equipado con 6.2 GB de SRAM de alta banda ancha en chip y 1 TB de DRAM GDDR6. La arquitectura prioriza mantener los datos cerca de las unidades de cómputo para reducir la latencia, empleando SRAM para el almacenamiento crítico de pesos expertos y transmitiendo el resto desde DRAM. Los sistemas Galaxy se interconectan mediante Ethernet estándar, facilitando la escalabilidad flexible desde un servidor único hasta clústeres de múltiples máquinas.
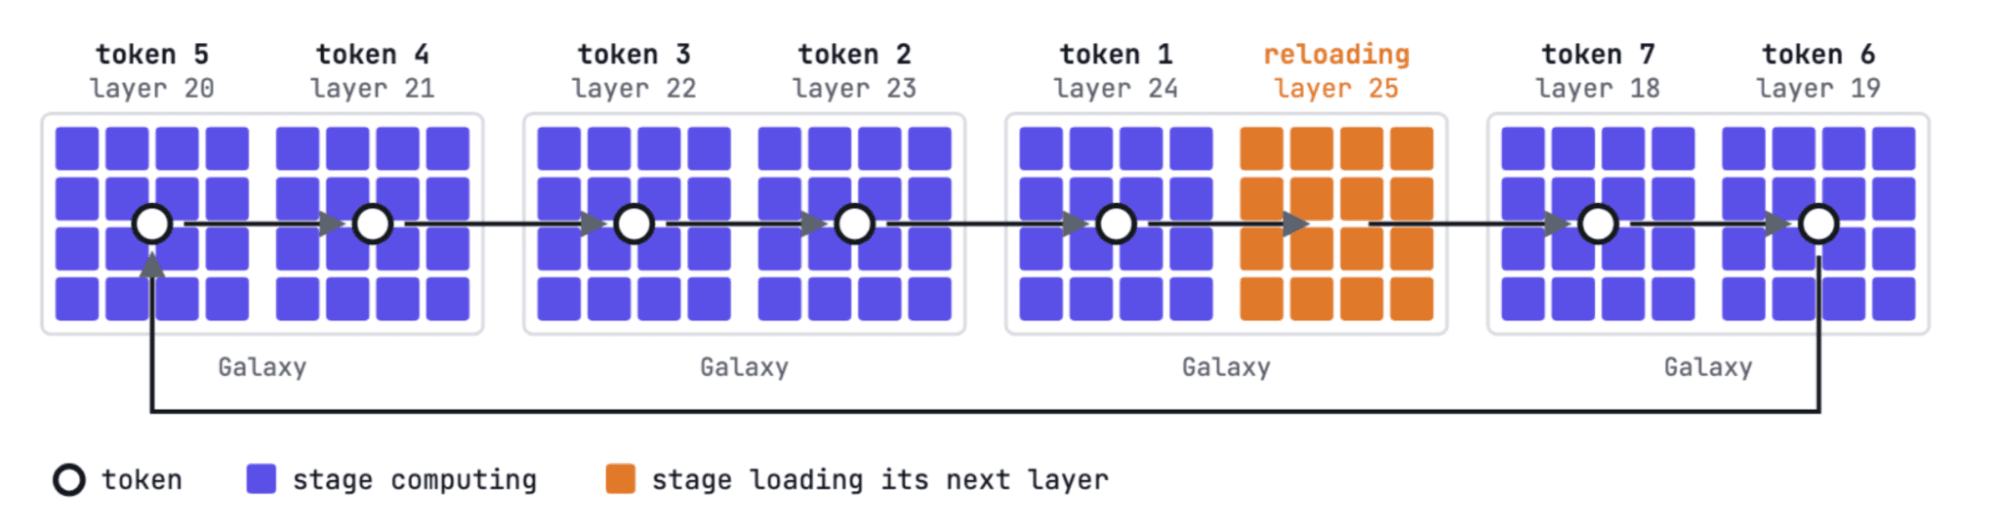
La arquitectura de implementación divide cada capa del modelo a través de una malla 4×4 de 16 chips Blackhole. El sistema reutiliza etapas de la tubería: mientras una etapa procesa la capa actual, los pesos de la siguiente se cargan en SRAM, maximizando la utilización del hardware. Los chips transmiten activaciones entre etapas a través de enlaces Ethernet directos y de baja latencia, organizados para reflejar el cableado físico, permitiendo un cálculo distribuido eficiente en múltiples máquinas.
Las pruebas en el conjunto de datos GSM8K, que consta de aproximadamente 8,500 problemas matemáticos de nivel primaria que requieren razonamiento paso a paso, mostraron que Galaxy promedió 3,000 tokens por segundo por usuario con una precisión del 95.8%. Las velocidades máximas alcanzaron los 5,300 tokens por segundo por usuario, centradas en operaciones de decodificación con indicaciones cortas, excluyendo la latencia de generación del token inicial.
Esta demostración destaca la capacidad de Tenstorrent para ofrecer inferencia rápida, precisa y escalable para grandes modelos MoE en hardware abierto. Las organizaciones que planifiquen despliegues que requieran inferencia de IA de baja latencia pueden evaluar las capacidades de Galaxy para equilibrar rendimiento, escalabilidad y costo. La naturaleza modular de Galaxy soporta una ampliación gradual desde configuraciones unitarias hasta clústeres extensos de múltiples nodos.
Tenstorrent continúa innovando en el diseño eficiente de aceleradores de IA, enfatizando un movimiento de datos optimizado y el balance entre capacidad de memoria y proximidad computacional. Las partes interesadas pueden contactar a Tenstorrent para más detalles o explorar Galaxy para sus necesidades de infraestructura de inferencia de IA.

Fuentes e informes originales
Read the original source ↗
Comentarios (0)
Aún no hay comentarios.
Escribe un comentario
Los comentarios se publican tras moderación. Tu nombre y comentario serán públicos. Cuenta