
Tenstorrent Galaxy erreicht 5.300 Tokens pro Sekunde Dekodiergeschwindigkeit auf OpenAIs gpt-oss-120b Modell
Image: Tenstorrent · Source
Das Galaxy-System von Tenstorrent betreibt OpenAIs gpt-oss-120b mit bis zu 5.300 Tokens pro Sekunde pro Nutzer unter Verwendung von acht verbundenen Galaxy-Clustern und nutzt dabei eine Mixture-of-Experts-Architektur sowie ein effizientes Hardware-Design.
Tenstorrent hat branchenführende Leistung demonstriert, indem es OpenAIs Open-Weight-Sprachmodell gpt-oss-120b betreibt und Dekodiergeschwindigkeiten von bis zu 5.300 Tokens pro Sekunde pro Nutzer auf einem Cluster von acht Galaxy-Systemen erreicht. Diese Leistung stellt einen bedeutenden Fortschritt in der effizienten großen Modellausführung für reaktionsfähige KI-Anwendungen dar.
Das gpt-oss-120b Modell verwendet eine Mixture-of-Experts (MoE) Architektur, bei der jeder Token nur durch 4 der 128 Expertenkomponenten geleitet wird, anstatt das gesamte Modell zu aktivieren. Diese selektive Aktivierung ermöglicht es dem Modell, etwa 5,1 Milliarden seiner 117 Milliarden Parameter pro Token zu verwenden, was die Recheneffizienz erhöht, ohne Genauigkeit einzubüßen.
Das Galaxy-System von Tenstorrent integriert 32 Blackhole-Chips in einem kompakten 6U-Server, ausgestattet mit 6,2 GB hochbandbreitigem On-Chip-SRAM und 1 TB GDDR6-DRAM. Die Architektur priorisiert die Nähe der Daten zu den Recheneinheiten, um Latenzen zu reduzieren, verwendet SRAM für die kritische Speicherung der Expertengewichte und streamt den Rest aus dem DRAM. Galaxy-Systeme sind über Standard-Ethernet verbunden, was eine flexible Skalierung von einem einzelnen Server bis zu Multi-Maschinen-Clustern ermöglicht.
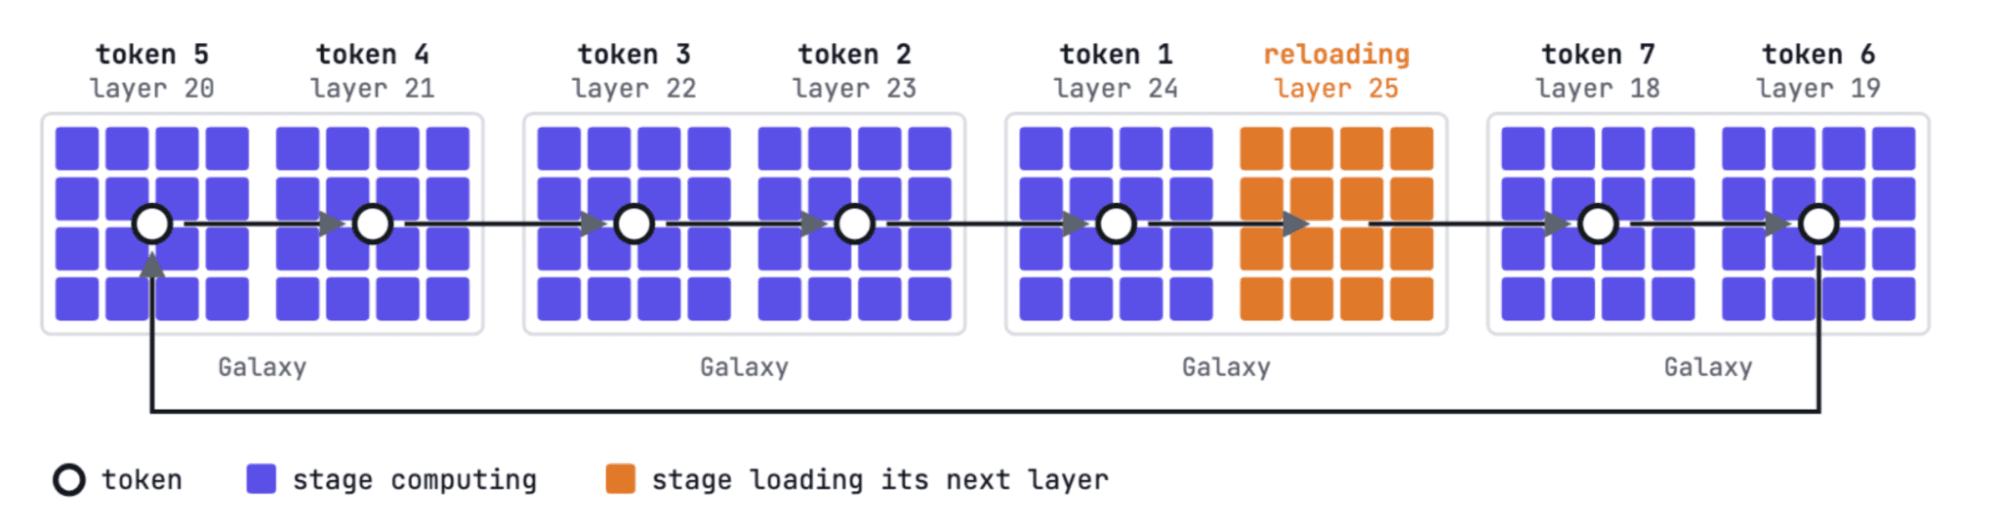
Die Deployment-Architektur teilt jede Modellebene über ein 4×4-Mesh aus 16 Blackhole-Chips auf. Das System nutzt Pipeline-Stufen wieder – während eine Stufe die aktuelle Ebene verarbeitet, werden die Gewichte der nächsten Ebene in SRAM geladen – um die Hardware-Auslastung zu maximieren. Chips übergeben Aktivierungen zwischen Stufen über direkte, latenzarme Ethernet-Verbindungen, die so angeordnet sind, dass sie die physische Verkabelung widerspiegeln und effiziente verteilte Berechnung über mehrere Maschinen ermöglichen.
Tests mit dem GSM8K-Datensatz, der etwa 8.500 Mathematik-Wortprobleme der Grundschule umfasst, die schrittweises logisches Denken erfordern, ergaben, dass Galaxy im Mittel 3.000 Tokens pro Sekunde pro Nutzer mit einer Genauigkeit von 95,8 % erreichte. Spitzenwerte von 5.300 Tokens pro Sekunde pro Nutzer wurden erreicht, konzentriert auf Dekodieroperationen mit kurzen Eingaben, wobei die Initial-Latenz der Token-Generierung nicht eingerechnet wurde.
Diese Demonstration unterstreicht Tenstorrents Fähigkeit, schnelle, genaue und skalierbare Inferenz für große MoE-Modelle auf offener Hardware bereitzustellen. Organisationen, die Einsätze planen, die latenzarme KI-Inferenz erfordern, könnten Galaxys Fähigkeiten bewerten, um Leistung, Skalierbarkeit und Kosten auszubalancieren. Die modulare Natur von Galaxy unterstützt eine schrittweise Skalierung von Einzelgeräte-Setups bis hin zu umfangreichen Multi-Knoten-Clustern.
Tenstorrent setzt seine Innovationen im Bereich effizienter KI-Beschleuniger fort, mit Schwerpunkt auf optimiertem Datenfluss sowie dem Gleichgewicht zwischen Speicherkapazität und Rechnernähe. Interessierte Parteien können Kontakt mit Tenstorrent aufnehmen für weitere Details oder Galaxy für ihre KI-Inferenz-Infrastrukturbedürfnisse erkunden.

Quellen und Originalberichte
Read the original source ↗
Kommentare (0)
Noch keine Kommentare.
Kommentar schreiben
Kommentare erscheinen nach Moderation. Name und Kommentar werden öffentlich angezeigt. Konto