
Tenstorrent Galaxy saavuttaa 5 300 tunnisteen sekuntinopeuden dekoodauksessa OpenAI:n gpt-oss-120b-mallilla
Kuva: Tenstorrent · Lähde
Tenstorrentin Galaxy-järjestelmä suorittaa OpenAI:n gpt-oss-120b-mallia jopa 5 300 tunnisteen sekuntinopeudella käyttäjää kohden kahdeksan yhdistetyn Galaxy-klusterin avulla, hyödyntäen asiantuntijoiden sekoitusarkkitehtuuria ja tehokasta laitteistosuunnittelua.
Tenstorrent on osoittanut alan huippusuorituskykyä ajamalla OpenAI:n avoimen painon kielimallia, gpt-oss-120b, saavuttaen dekoodausnopeuden jopa 5 300 tunnistetta sekunnissa käyttäjää kohti kahdeksan Galaxy-järjestelmän klusterissa. Tämä suorituskyky merkitsee merkittävää edistystä tehokkaassa suurten mallien päätelmässä reagoivien tekoälysovellusten tarpeisiin.
Gpt-oss-120b-malli hyödyntää Mixture-of-Experts (MoE) -arkkitehtuuria, jossa kukin tunniste ohjataan vain neljän 128 asiantuntijakomponentin läpi sen sijaan, että koko malli aktivoitaisiin. Tämä valikoiva aktivointi mahdollistaa mallin käyttävän noin 5,1 miljardia sen 117 miljardista parametristä per tunniste, parantaen laskentatehokkuutta ilman tarkkuuden heikkenemistä.
Tenstorrentin Galaxy-järjestelmä integroi 32 Blackhole-piiriä kompaktissa 6U-palvelimessa, jossa on 6,2 GB korkean kaistanleveyden sirun sisäistä SRAM-muistia ja 1 TB GDDR6 DRAM-muistia. Arkkitehtuurissa priorisoidaan datan pitäminen lähellä laskentayksiköitä latenssin vähentämiseksi, käyttämällä SRAM:ia kriittisten asiantuntijapainojen säilytykseen ja striimaamalla muu data DRAM:ista. Galaxy-järjestelmät yhdistetään tavallisen Ethernetin yli, mahdollistaen joustavan skaalaamisen yhdestä palvelimesta monikoneklustereiksi.
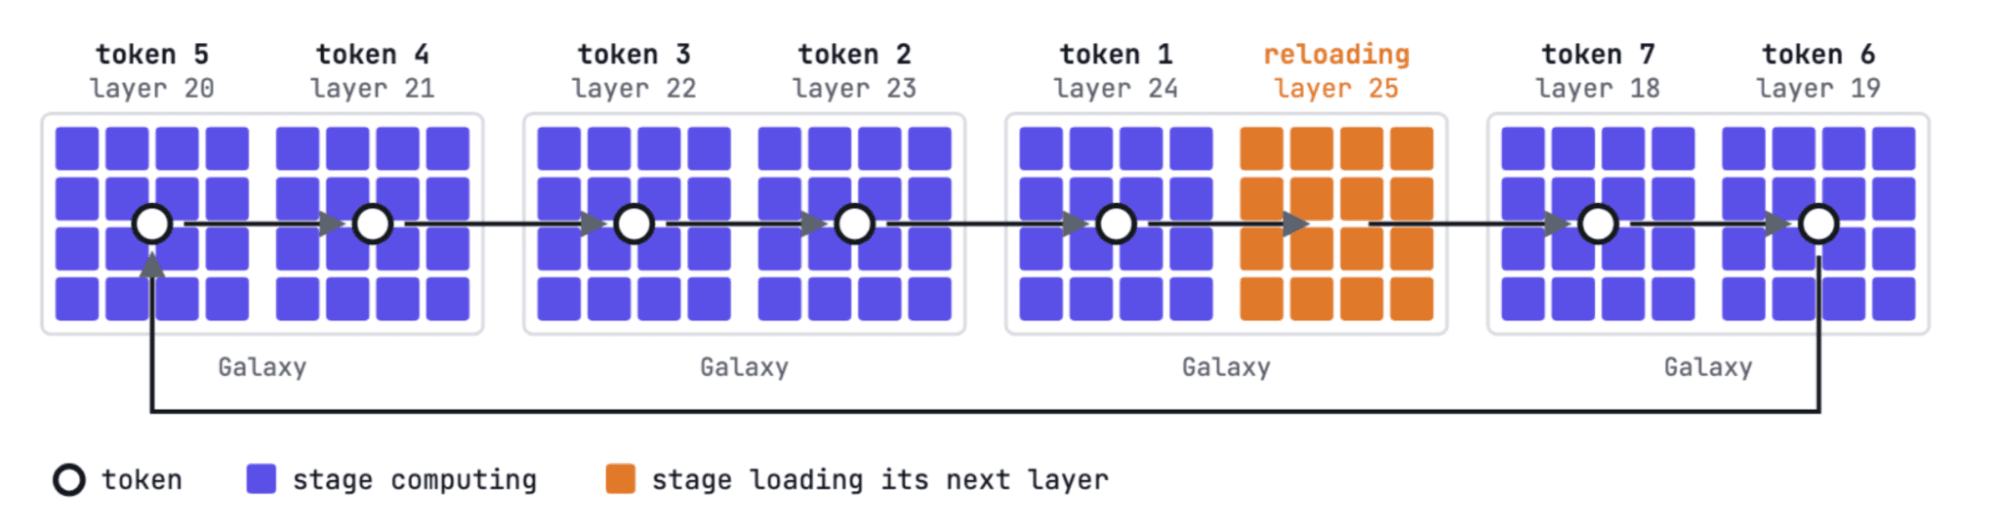
Käyttöönottorakenne jakaa jokaisen mallikerroksen 4×4-verkolle, joka koostuu 16 Blackhole-piiristä. Järjestelmä käyttää putkistovaiheiden uudelleenkäyttöä – kun yksi vaihe käsittelee nykyistä kerrosta, seuraavan kerroksen painot ladataan SRAM-muistiin – maksimoiden laitteiston käyttöasteen. Piirit välittävät aktivaatioita vaiheiden välillä suoraan, alhaisen latenssin Ethernet-linkkien kautta, jotka on järjestetty vastaamaan fyysisiä kaapelointeja, mahdollistaen tehokkaan hajautetun laskennan useissa koneissa.
Testauksessa GSM8K-aineistolla, joka koostuu noin 8 500 peruskoulutason matematiikan sanallisesta ongelmasta vaativasta vaiheittaisesta päättelystä, Galaxy saavutti keskimäärin 3 000 tunnistetta sekunnissa käyttäjää kohden 95,8 % tarkkuudella. Huippunopeudet ylsivät 5 300 tunnisteeseen sekunnissa käyttäjää kohti, keskittyen dekoodausoperaatioihin lyhyillä kehotteilla, alustavan tunnisteen generointiviiveen ollessa pois laskuista.
Tämä demonstraatio korostaa Tenstorrentin kykyä tarjota nopeaa, tarkkaa ja skaalautuvaa päätelmää suurille MoE-malleille avoimella laitteistolla. Organisaatiot, jotka suunnittelevat käyttöönottoja, jotka vaativat pienen latenssin tekoälypäätelmää, voivat arvioida Galaxyn kyvykkyyksiä suorituskyvyn, skaalautuvuuden ja kustannusten tasapainottamiseksi. Galaxyn modulaarinen rakenne tukee asteittaista skaalausta yhden yksikön kokoonpanoista laajoihin monisolmuklustereihin.
Tenstorrent jatkaa innovaatiota tehokkaiden tekoälykiihdyttimien suunnittelussa korostaen virtaviivaista datan liikettä ja tasapainoa muistikapasiteetin ja laskennan läheisyyden välillä. Kiinnostuneet tahot voivat ottaa yhteyttä Tenstorrentiin saadakseen lisätietoja tai tutustua Galaxyyn tekoälypäätelmäinfrastruktuurin tarpeisiin.

Lähteet ja alkuperäiset raportit
Lue alkuperäinen lähde ↗
Kommentit (0)
Ei vielä kommentteja. Aloita keskustelu.
Kirjoita kommentti
Kommentit julkaistaan moderoinnin jälkeen. Nimesi ja kommenttisi näkyvät julkisesti. Tili