
Tenstorrent Galaxy sasniedz 5 300 tokenu sekundē dekodēšanas ātrumu OpenAI gpt-oss-120b modelī
Attēls: Tenstorrent · Avots
Tenstorrent Galaxy sistēma darbina OpenAI gpt-oss-120b līdz pat 5 300 tokeniem sekundē uz lietotāju astoņu savienotu Galaxy klasteru režīmā, izmantojot ekspertu kombinācijas arhitektūru un efektīvu aparatūru.
Tenstorrent ir demonstrējis nozares līdera veiktspēju, darbinot OpenAI atvērtā svara valodas modeli gpt-oss-120b, sasniedzot dekodēšanas ātrumu līdz 5 300 tokeniem sekundē uz lietotāju astoņu Galaxy sistēmu klastrā. Šis rezultāts nozīmē būtisku progresu efektīvā lielu modeļu inferencē reaģējošām mākslīgā intelekta aplikācijām.
Gpt-oss-120b modelis izmanto eksperta kombinācijas (Mixture-of-Experts, MoE) arhitektūru, kur katrs tokens tiek apstrādāts caur četriem no 128 ekspertu komponentiem, nevis aktivizējot visu modeli vienlaikus. Šī selektīvā aktivācija ļauj modelim izmantot aptuveni 5,1 miljardu no tā 117 miljardiem parametriem katram tokenam, palielinot aprēķinu efektivitāti nepazeminot precizitāti.
Tenstorrent Galaxy sistēma integrē 32 Blackhole mikroshēmas kompakta 6U servera iekārtā, aprīkota ar 6,2 GB augstas joslas platuma SRAM uz mikroshēmas un 1 TB GDDR6 DRAM. Arhitektūra prioritē datu izvietošanu tuvu aprēķinu vienībām, lai samazinātu latentumu, izmantojot SRAM kritisko ekspertu svaru glabāšanai un pārējo straumēšanai no DRAM. Galaxy sistēmas savienojas izmantojot standarta Ethernet, nodrošinot elastīgu skalēšanu no viena servera līdz daudzām mašīnām klastrā.
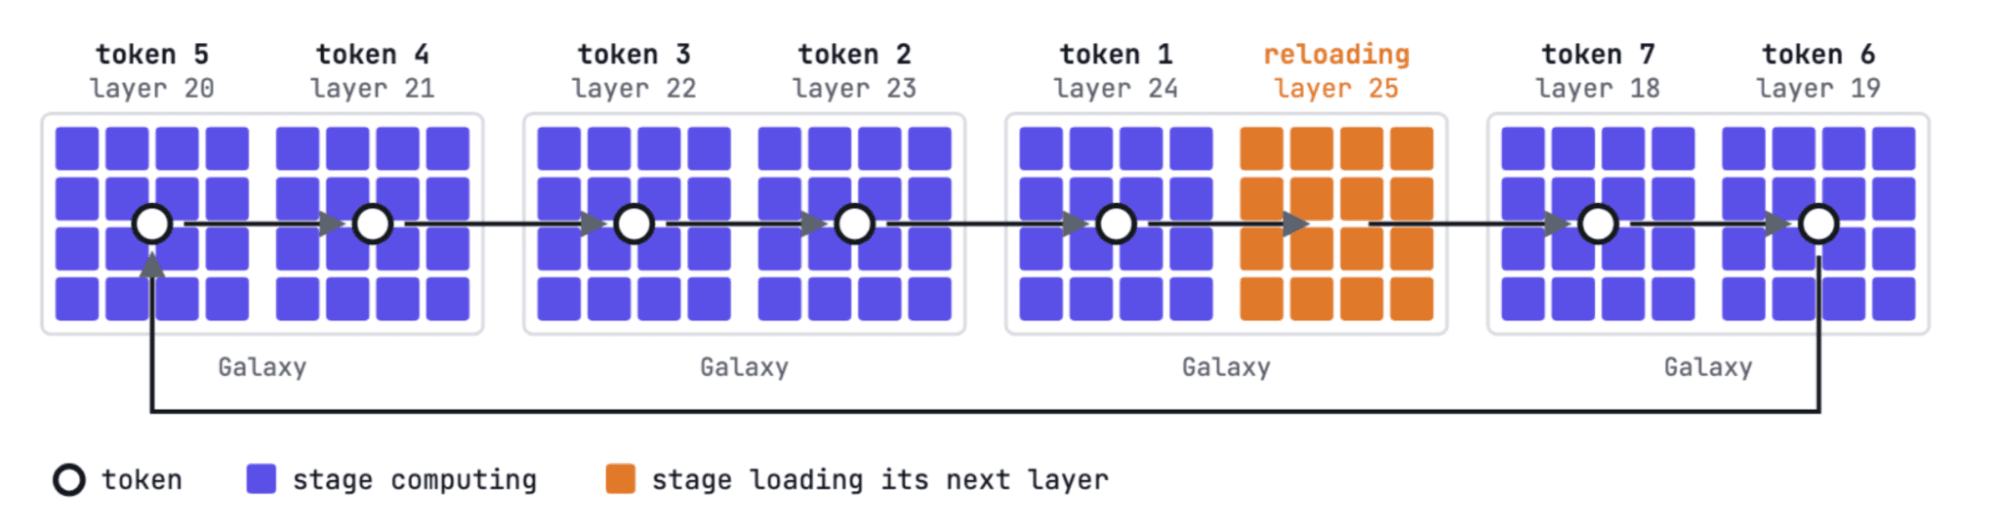
Ievietošanas arhitektūra dala katru modeļa slāni 4×4 režģī ar 16 Blackhole mikroshēmām. Sistēma atkārtoti izmanto cauruļvadu posmus — kamēr viens posms apstrādā pašreizējo slāni, nākamā slāņa svari tiek ielādēti SRAM — maksimāli izmantojot aparatūras resursus. Mikroshēmas pārraida aktivācijas starp posmiem caur tiešām, zemas latentuma Ethernet saitēm, kas atspoguļo fiziskās kabeļu savienojumus, nodrošinot efektīvu sadalīto skaitļošanu vairākās mašīnās.
Pārbaudēs ar GSM8K datu kopu, kurā ir apmēram 8 500 pamatskolas matemātikas vārdproblemātikas uzdevumu, kas prasa pakāpenisku risināšanu, Galaxy vidēji sasniedza 3 000 tokenus sekundē uz lietotāju ar precizitāti 95,8%. Maksimālie ātrumi sasniedza 5 300 tokenus sekundē uz lietotāju, koncentrējoties uz dekodēšanas operācijām ar īsiem uzstādījumiem, neiekļaujot pirmā tokena ģenerēšanas latentumu.
Šī demonstrācija izceļ Tenstorrent spēju nodrošināt ātru, precīzu un mērogojamu inferenci lieliem MoE modeļiem atvērtā aparatūrā. Organizācijas, kas plāno izvietojumus ar zemu latentumu AI inferencē, var novērtēt Galaxy spējas līdzsvarot veiktspēju, mērogojamību un izmaksas. Galaxy modulārais raksturs atbalsta pakāpenisku paplašināšanos no vienas vienības līdz plašam daudzmezglu klastrim.
Tenstorrent turpina inovācijas efektīvu AI paātrinātāju dizainā, uzsverot optimizētu datu pārvietošanu un atmiņas kapacitātes un aprēķinu tuvuma līdzsvaru. Interesenti var sazināties ar Tenstorrent papildu informācijām vai izpētīt Galaxy sava AI inferces infrastruktūras nodrošinājuma vajadzībām.

Avoti un oriģinālziņas
Lasīt oriģinālo avotu ↗
Komentāri (0)
Komentāru vēl nav. Sāciet diskusiju.
Rakstīt komentāru
Komentāri tiek publicēti pēc moderēšanas. Jūsu vārds un komentārs būs redzami publiski. Konts