
Tenstorrent Galaxy pasiekia 5 300 žetonų per sekundę dekodavimo greitį OpenAI gpt-oss-120b modelyje
Vaizdas: Tenstorrent · Šaltinis
Tenstorrent Galaxy sistema vykdo OpenAI gpt-oss-120b modelį iki 5 300 žetonų per sekundę vienam vartotojui naudodama aštuonis sujungtus Galaxy klasterius, pasitelkdama Mixture-of-Experts architektūrą ir efektyvų aparatinės įrangos dizainą.
Tenstorrent demonstravo pramonės lyderių pasiekimus, paleisdama OpenAI atviro svorio kalbos modelį gpt-oss-120b ir pasiekdama dekodavimo greitį iki 5 300 žetonų per sekundę vienam vartotojui aštuonių Galaxy sistemų klasteryje. Šis našumas žymi reikšmingą pažangą efektyviame didelių modelių inferencijoje, skirtoje greitoms dirbtinio intelekto programoms.
Gpt-oss-120b modelis naudoja Mixture-of-Experts (MoE) architektūrą, kur kiekvienas žetonas nukreipiamas per tik 4 iš 128 ekspertų komponentų, o ne aktyvinamas visas modelis. Ši selektyvi aktyvacija leidžia modeliui naudoti maždaug 5,1 milijardo iš 117 milijardų parametrų vienam žetonui, pagerindama skaičiavimo efektyvumą neaukojant tikslumo.
Tenstorrent Galaxy sistema integruoja 32 Blackhole lustus kompaktiškame 6U serveryje, aprūpintame 6,2 GB didelės pralaidumo už lustų esančios SRAM atminties ir 1 TB GDDR6 DRAM. Architektūra prioritetą teikia duomenų laikymui arti skaičiavimo blokų, kad sumažintų vėlavimą, naudojant SRAM kritinių ekspertų svoriams saugoti ir kitus duomenis transliuojant iš DRAM. Galaxy sistemos sujungiamos įprastu Ethernet, leidžiančiu lanksčiai mastelizuoti nuo vieno serverio iki daugiamačių klasterių.
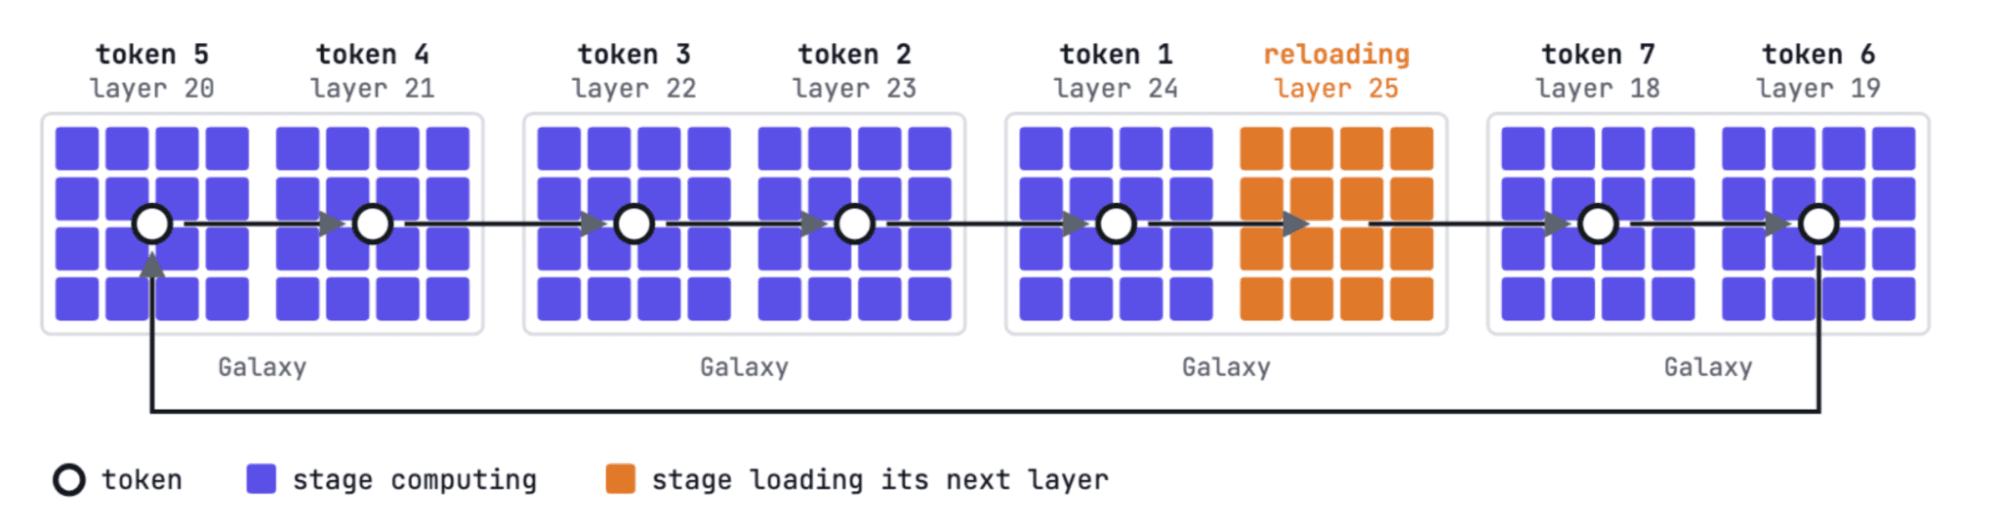
Įdiegimo architektūra padalija kiekvieną modelio sluoksnį 4×4 tinklelyje iš 16 Blackhole lusto vienetų. Sistema pakartotinai naudoja etapų apdorojimą – kol vienas etapas apdoroja dabartinį sluoksnį, kito sluoksnio svoriai kraunami į SRAM, maksimaliai išnaudojant aparatinės įrangos galimybes. Lustai perduoda aktyvacijas tarp etapų tiesioginiais, mažo delsimo Ethernet ryšiais, išdėstytais taip, kad atspindėtų fizinius kabelių laidus, leidžiant efektyvią paskirstytą skaičiavimą tarp kelių mašinų.
Testavimas GSM8K duomenų rinkinyje, kuriame yra apie 8 500 pradinės mokyklos lygio matematikos problemų reikalaujančių žingsninių sprendimų, parodė Galaxy vidutinį našumą: 3 000 žetonų per sekundę vienam vartotojui su 95,8 % tikslumu. Maksimalūs greičiai pasiekė 5 300 žetonų per sekundę vienam vartotojui, orientuojantis į dekodavimo operacijas su trumpais užklausų tekstais, neįskaitant pradinių žetonų generavimo delsos.
Ši demonstracija pabrėžia Tenstorrent gebėjimą suteikti greitą, tikslų ir skalę palaikantį inferencijos sprendimą dideliems MoE modeliams atviroje aparatinėje įrangoje. Organizacijos, planuojančios sprendimus su mažo vėlavimo DI inferencija, gali įvertinti Galaxy galimybes, suderinančias našumą, mastelį ir sąnaudas. Moduliari Galaxy konstrukcija palaiko laipsnišką mastelį nuo vienetinių įrenginių iki plataus masto daugianodžių klasterių.
Tenstorrent toliau inovuoja efektyvios DI akceleratorių dizaino srityje, pabrėždama efektyvų duomenų judėjimą ir pusiausvyrą tarp atminties talpos ir skaičiavimo artumo. Susidomėjusieji gali kreiptis į Tenstorrent dėl papildomos informacijos arba išbandyti Galaxy jų DI inferencijos infrastruktūros poreikiams.

Šaltiniai ir originalūs pranešimai
Skaityti originalų šaltinį ↗
Komentarai (0)
Komentarų dar nėra. Pradėkite diskusiją.
Rašyti komentarą
Komentarai publikuojami po moderavimo. Jūsų vardas ir komentaras bus vieši. Paskyra