
NVIDIA DGX Spark 64GB: En Praktisk Lokal AI-plattform för Utvecklare och Forskare
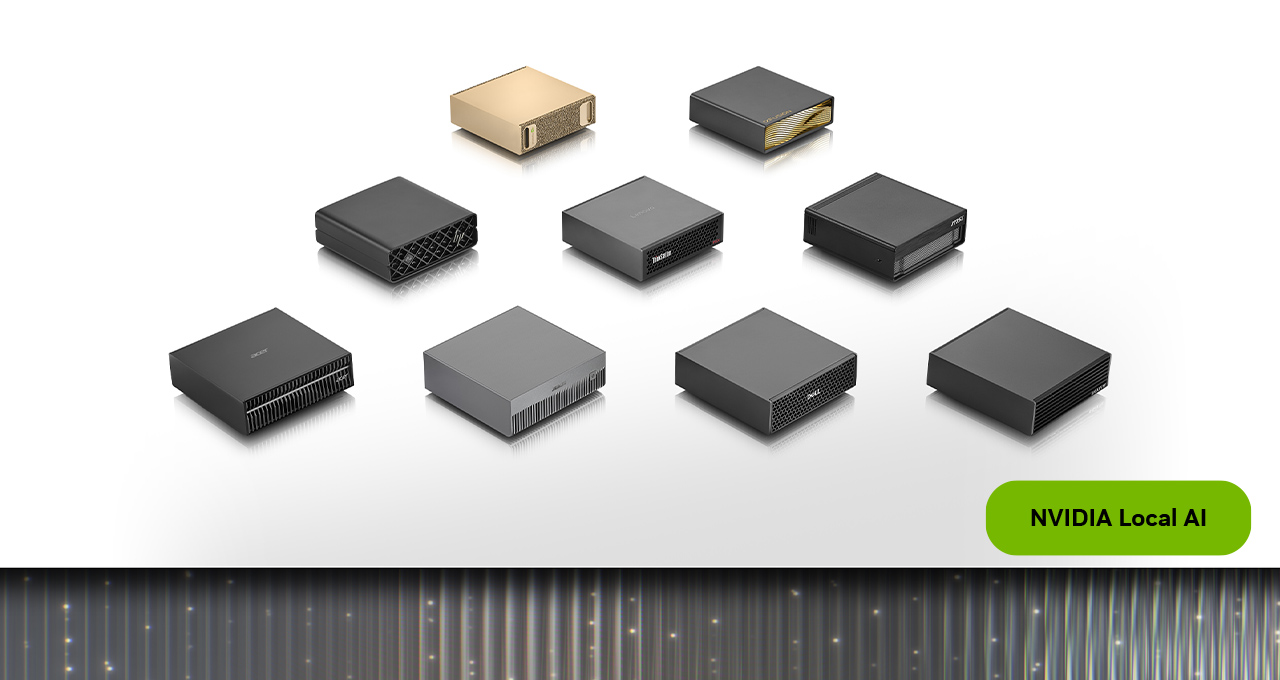
Bild: NVIDIA · Källa
NVIDIA DGX Spark 64GB erbjuder en kompakt, skalbar lokal AI-superdatorlösning som möjliggör distribution och skalning av agentbaserade AI-modeller med upp till 100 miljarder parametrar direkt på enheten. Den stödjer sömlös multi-nod klustring och levereras förinstallerad med NVIDIAs AI-mjukvarustack för omedelbar produktivitet.
Introduktion till NVIDIA DGX Spark 64GB
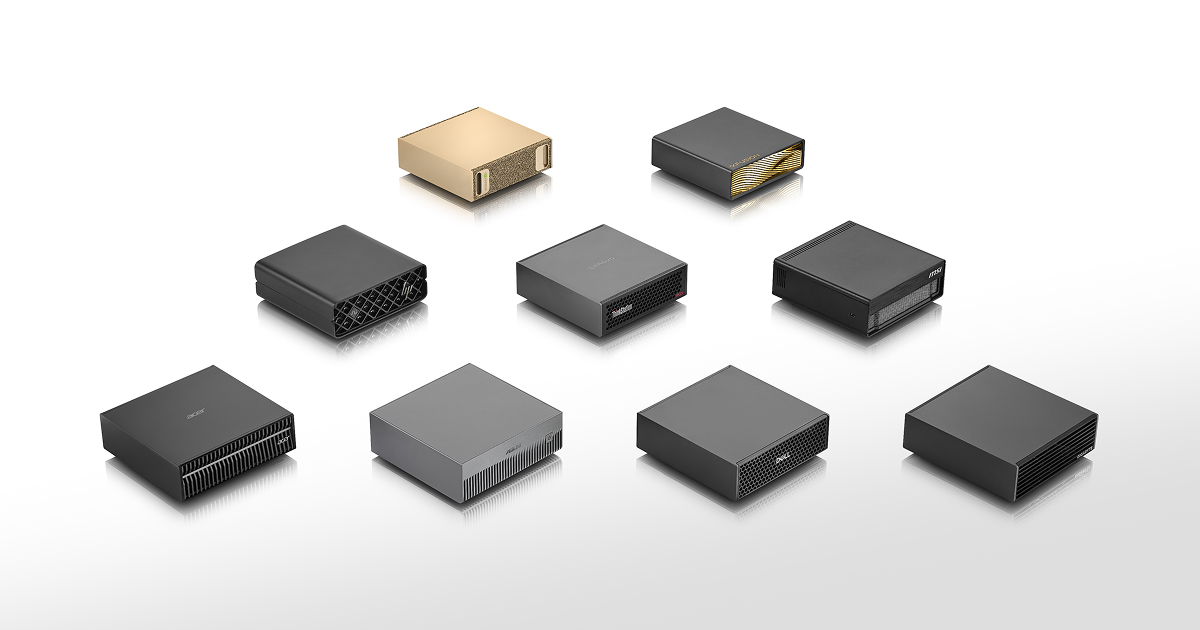
NVIDIA DGX Spark 64GB är en specialiserad lokal AI-beräkningsplattform som är utformad för att ge AI-utvecklare, forskare och entusiaster kraftfulla, privata och skalbara AI-möjligheter lokalt. Plattformen utvecklades i samarbete med ledande hårdvaruleverantörer som Acer, ASUS, Dell, Gigabyte, HP och MSI och integrerar avancerad hårdvara och mjukvara optimerad för agentbaserade AI-applikationer, inferens, finjustering och datavetenskapliga uppgifter.
Med 64GB unifierat minne och NVIDIA Grace Blackwell Superchip som kärna stödjer DGX Spark 64GB körning av stora språkmodeller – upp till 100 miljarder parametrar direkt på enheten – utan beroende av molninfrastruktur. Denna kapacitet möter den ökande efterfrågan på lokal AI-beräkning med fördelar vad gäller integritet och latens.
Arkitektur- och hårdvaruöversikt
I hjärtat av DGX Spark 64GB finns NVIDIA GB10 Grace Blackwell Superchip, en arkitektur anpassad för att optimera AI-arbetsbelastningar med fokus på enhetligt minnesdesign. De 64GB enhetliga minnet tillåter att stora modeller laddas helt i minnet, vilket minskar datarörelse och accelererar inferens och finjustering.
Nätverk möjliggörs av den integrerade NVIDIA ConnectX-7 NIC som stödjer upp till 200 Gigabit Ethernet, vilket möjliggör höggenomströmning och låg latens för klustring av flera DGX Spark-enheter. Denna kombination av beräkningskraft, minne och nätverkshårdvara positionerar enheten som en kompakt men kapabel personlig AI-superdator.
Plattformen kör DGX OS, NVIDIAs specialiserade operativsystem för AI-arbetsbelastningar, och innehåller en AI-mjukvarustack optimerad med CUDA-X AI-bibliotek och stöd för populära ramverk. Denna integration säkerställer acceleration direkt vid start för PyTorch, Ollama, vLLM och andra körmiljöer samt tillgång till öppna stora språkmodeller som Nemotron.
Skalbarhet via NVIDIA Sync Cluster Assistant
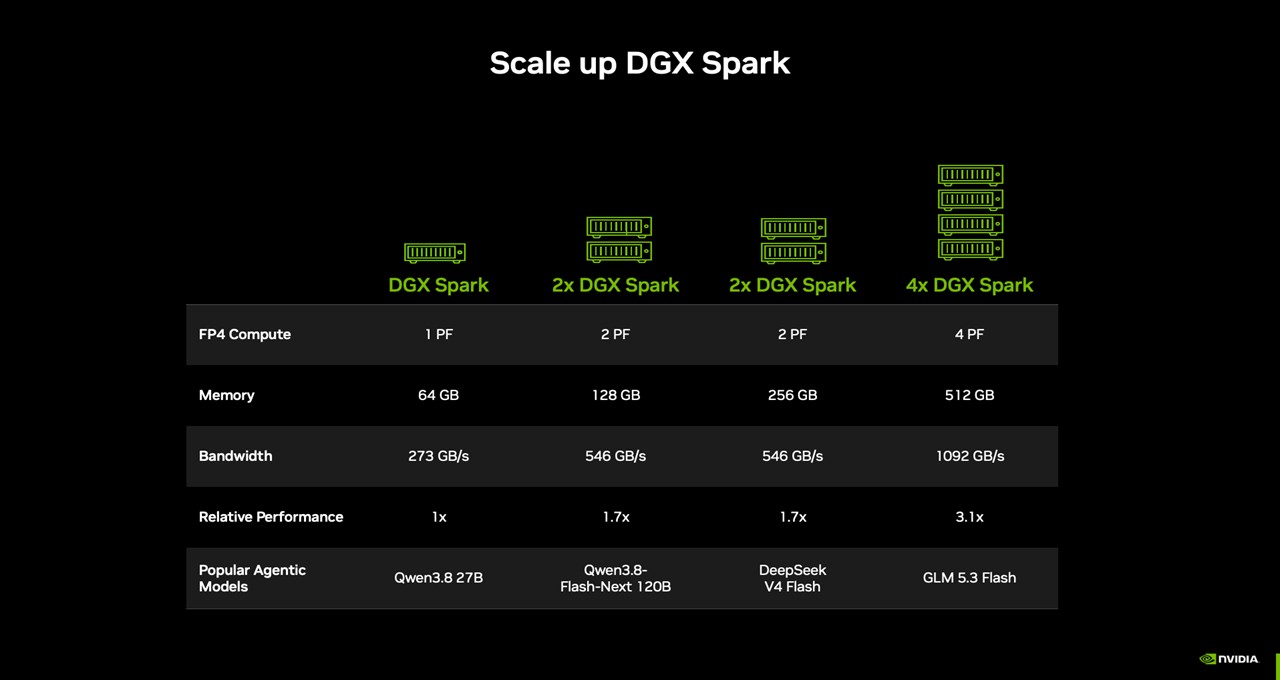
En viktig innovation i DGX Spark 64GB är dess sömlösa skalbarhet möjliggjord av NVIDIA Sync Cluster Assistant. Denna mjukvara orkestrerar klustring av två DGX Spark-enheter via deras ConnectX-7 NICs genom en QSFP-kabel utan krav på manuell nätverks- eller mjukvarukonfiguration.
Genom att poola de två 64GB-enheterna erhålls 128GB enhetligt minne, vilket effektivt möjliggör körning av modeller på upp till 200 miljarder parametrar och upp till 1,7 gånger prestanda jämfört med en enhet. NVIDIAs interna tester med Qwen 3.8 27B-modellen indikerar verklig prestanda- och kapacitetsökning bortom enbart fördubbling av minnet.
Sync Cluster Assistant upptäcker automatiskt anslutna noder, validerar enhetsstatus och konfigurerar nätverket, vilket förenklar övergången från enkel-nods- till multi-nods-miljöer. Enhetliga mjukvarustackar över noder medför att utvecklare inte behöver justera distributioner vid skalning.
Mjukvarustack och utvecklarverktyg
DGX Spark levereras förinstallerat med ett omfattande NVIDIA AI-mjukvaruekosystem designat för att påskynda AI-utveckling:
- **NVIDIA Agent Toolkit:** Stöder lokala autonoma AI-agenter som utför komplexa och flerstegsuppgifter.
- **CUDA-X AI Libraries:** Levererar GPU-accelererad prestanda för AI-arbetsbelastningar inklusive träning och inferens.
- **Öppna stora språkmodeller:** Inkluderar tillgång till modeller som Nemotron för omedelbar distribution eller finjustering.
- **Stödda körmiljöer:** Kompatibilitet med populära körmiljöer såsom Ollama, vLLM, llama.cpp och PyTorch med CUDA, vilket ger flexibilitet för utvecklare.
- **Kommande NVIDIA Sync Model Launcher:** Ett grafiskt gränssnitt som förväntas förenkla lansering av stora modeller såsom Qwen 3.8 27B på enskilda eller klustrade enheter, samtidigt som det hanterar distribuerad modulkörning och åtkomst från bärbara datorer.
Detta omfattande verktygspaket gör det möjligt för användare att snabbt gå från hårdvaruinstallation till produktiv AI-applikationsutveckling.
Exempel Arbetsflöde 1: Köra en Beständig AI-Agent för Kodning och Forskning
**Användare:** Mjukvaruutvecklare eller forskare som behöver löpande AI-stöd för kodgranskning, dokumentanalys eller komplex uppgiftsautomation.
**Förutsättningar:** En DGX Spark 64GB med NVIDIA Agent Toolkit.
**Steg:** 1. Starta DGX Spark och öppna den förinstallerade NVIDIA AI-mjukvarustacken. 2. Distribuera en autonom AI-agent anpassad för kod- eller dokumentanalys med Agent Toolkit. 3. Integrera relevanta datamängder eller projektfiler i agentens miljö. 4. Om efterfrågan ökar, anslut en andra DGX Spark 64GB med NVIDIA Sync Cluster Assistant för att öka kapacitet och köra flera samtidiga agenter.
**Lyckat resultat:** En kontinuerligt körande lokal AI-agent som kan assistera användare i realtid utan beroende av molntjänster, gynnsamt för arbetsflöden som kräver integritet och låg latens.
**Överväganden:** Termisk hantering och tillräcklig strömförsörjning är kritiska för kontinuerlig drift. Modellstorlek måste anpassas till tillgängligt minne och skalas därefter.
Exempel Arbetsflöde 2: Stöd för AI-drivna Kreativa Applikationer på Användar-PC
**Användare:** Grafiska formgivare eller kreativa yrkespersoner som vill utföra resursintensiv AI-inferens utan att belasta sina persondatorer.
**Förutsättningar:** DGX Spark tillgänglig på lokalt nätverk; klientenheter som kör kompatibel kreativ mjukvara.
**Steg:** 1. Host AI-inferensmodeller (till exempel text-till-bild eller språkmodeller) på DGX Spark. 2. Från användarstationer, nå dessa modeller via API:er eller integrationslager. 3. Använd kommande Blender-förinstallerare för direkt användning av DGX Spark AI-funktioner i kreativa arbetsflöden.
**Lyckat resultat:** AI-modellinferens utförs på DGX Spark vilket avlastar beräkningskravet från klientdatorerna, förbättrar responsivitet och möjliggör mer komplexa AI-stödda kreativa uppgifter.
**Överväganden:** Nätverkets tillförlitlighet och bandbredd kan påverka interaktivitet; säkra autentisering och dataöverföringsstrategier bör tillämpas.
Exempel Arbetsflöde 3: Skalning av AI-arbetsbelastningar med Ökande Krav
**Användare:** AI-forskare eller små företag som börjar med medelstora uppgifter men förväntar behov av större modeller eller flera samtidiga inferenser.
**Förutsättningar:** Två DGX Spark 64GB-enheter sammankopplade med QSFP-kablar.
**Steg:** 1. Börja med ett enda DGX Spark 64GB-system för grundläggande AI-arbetsbelastningar. 2. Lägg till en andra enhet och anslut dem via deras ConnectX-7 NICs. 3. Använd NVIDIA Sync Cluster Assistant för att upptäcka, konfigurera och verifiera multi-nod klustret. 4. Skala AI-arbetsbelastningar sömlöst med dubblerat unifierat minne och accelererad kommunikation mellan noder utan att ändra befintliga mjukvarustackar.
**Lyckat resultat:** Ökad kapacitet för att hantera större modeller, förlängda kontextfönster eller flera samtidiga AI-uppgifter.
**Överväganden:** Nuvarande skalning är begränsad till två fysiska noder; mjukvarulicenser och nätverkskonfigurationer måste följa NVIDIAs dokumenterade riktlinjer.
Exempel Arbetsflöde 4: Edge AI-utveckling och Finjustering
**Användare:** Datascientister och AI-utvecklare som arbetar med edge AI-applikationer som kräver modellfinjustering och inferens utan molnberoende.
**Förutsättningar:** En DGX Spark 64GB med DGX OS och tillgång till dataset för finjustering.
**Steg:** 1. Distribuera initiala bask modeller som ryms inom det 64GB enhetliga minnet. 2. Använd NVIDIA CUDA-X AI-bibliotek och PyTorch med CUDA för att utföra finjustering lokalt. 3. Testa modellimplementering på edge-enheter genom att simulera realtidsinferens med den lokala DGX Spark. 4. För skalbarhet, länka en andra DGX Spark 64GB med Sync Cluster Assistant för att hantera mer komplexa modeller eller flera samtidiga edge-simuleringar.
**Lyckat resultat:** Utvecklare kan snabbt iterera modellutformning och implementeringar med låg latens och full kontroll över data och modeller.
**Överväganden:** Datasetstorlek och modellkomplexitet måste hållas inom minnesbegränsningar om inte multi-nods-klustering används. Utvecklare bör verifiera att latens och realtidsrespons uppfyller applikationskrav.
Kompatibilitet, Underhåll och Säkerhetsöverväganden
Att upprätthålla en konsekvent mjukvaru- och hårdvarumiljö över DGX Spark-enheter förbättrar tillförlitlighet och förenklar uppdateringar. Organisationer bör tillämpa säkerhetsbästa praxis för att skydda känsliga data och infrastruktur vid distribution av lokala AI-kluster.
Backup av data, modeller och konfigurationer är användarens ansvar. Regelbunden övervakning av hårdvaruhälsa och prediktivt underhåll stödjer drifttid och systemets livslängd.
Nätverkssegmentering och brandväggar rekommenderas för att skydda enheterna i bredare IT-miljöer. Användare bör konsultera NVIDIAs dokumentation för detaljerade rutiner och efterlevnadsriktlinjer.
Plattformen stödjer ledande AI-ramverk och körmiljöer för bred kompatibilitet, men användare måste verifiera specifika integrationer med valt mjukvaruverktyg.
Produktanpassning och Begränsningar
NVIDIA DGX Spark 64GB är idealisk för AI-professionella som behöver en kraftfull, kompakt lokal AI-beräkningsplattform med skalbara alternativ. Dess arkitektur passar konfidentiell datahantering, iterativ AI-agentutveckling och arbetsbelastningar som kräver omedelbar lokal inferens.
Den är mindre lämplig för extremt storskaliga distribuerade AI-uppgifter som överskrider två-nods-kluster eller kräver hundratals miljarder parametrar. Organisationer med mycket strama budgetar eller begränsat fysiskt utrymme kan uppleva lösningen som mindre hanterbar.
Den initiala kostnaden och tillverkarberoende hårdvarukonfigurationer kräver utvärdering anpassad till organisatoriska behov och infrastruktur.
Slutsats
NVIDIA DGX Spark 64GB erbjuder en väl integrerad, skalbar och effektiv plattform för lokal AI-modellutveckling och distribution. Genom att kombinera avancerad CPU-GPU-arkitektur, omfattande enhetligt minne och strömlinjeformad klustring via NVIDIA Sync förenklas antagandet och skalningen av agentbaserade AI-arbetsbelastningar helt lokalt.
Förinstallerade mjukvarustackar och brett ramverksstöd möjliggör omedelbar produktivitet för utvecklare, medan multi-nod klustringsmöjligheter rymmer växande komplexitet i AI-arbetsbelastningar.
Denna recension är uteslutande baserad på officiell NVIDIA-produktdokumentation och blogginlägg från oktober 2026 och erbjuder en funktions- och arbetsflödesanalys utan oberoende praktisk utvärdering eller tredjepartsbenchmarking.
Källor och ursprunglig rapportering
Läs den ursprungliga källan ↗
Kommentarer (0)
Inga kommentarer ännu. Börja diskussionen.
Skriv en kommentar
Kommentarer publiceras efter granskning. Ditt namn och kommentar syns offentligt. Konto