
NVIDIA DGX Spark 64GB: Praktyczna lokalna platforma AI dla programistów i badaczy
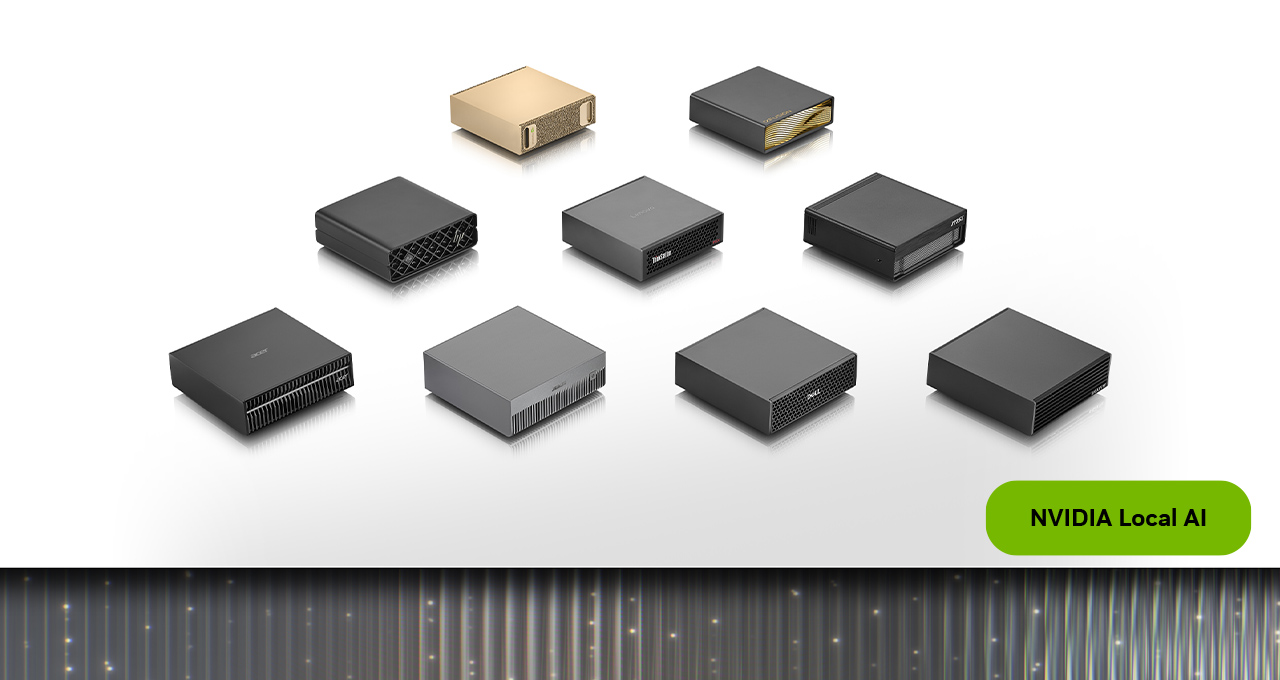
Image: NVIDIA · Source
NVIDIA DGX Spark 64GB oferuje kompaktowe, skalowalne lokalne rozwiązanie superkomputera AI, umożliwiające wdrażanie i skalowanie agentowych modeli AI o rozmiarze do 100 miliardów parametrów bezpośrednio na urządzeniu. Wspiera bezproblemowe klastrowanie wielowęzłowe i jest dostarczany z preinstalowanym stosie oprogramowania AI NVIDIA, co pozwala na natychmiastową produktywność.
Wprowadzenie do NVIDIA DGX Spark 64GB
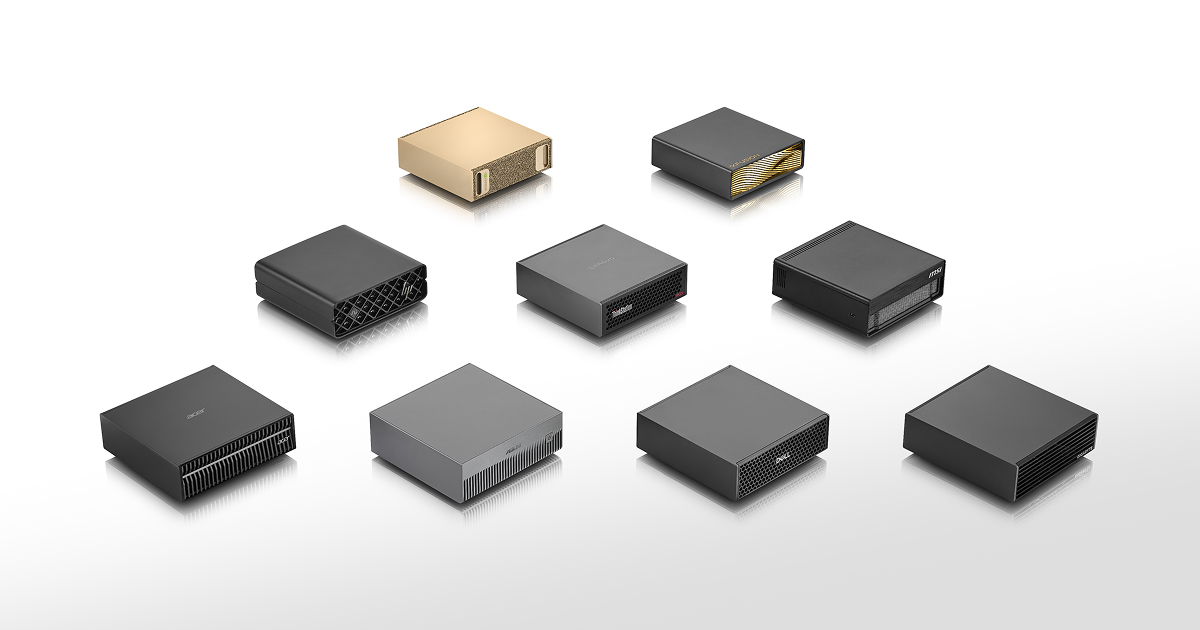
NVIDIA DGX Spark 64GB to specjalistyczna lokalna platforma obliczeniowa AI zaprojektowana, aby wspierać programistów AI, badaczy i entuzjastów, dostarczając potężne, prywatne i skalowalne możliwości AI na miejscu. Opracowana we współpracy z czołowymi producentami sprzętu, takimi jak Acer, ASUS, Dell, Gigabyte, HP i MSI, ta platforma integruje zaawansowany sprzęt i oprogramowanie zoptymalizowane pod kątem aplikacji agentowych AI, inferencji, dostrajania i zadań data science.
Dysponując 64GB zunifikowanej pamięci i rdzeniem NVIDIA Grace Blackwell Superchip, DGX Spark 64GB umożliwia uruchamianie znacznych modeli językowych — do 100 miliardów parametrów bezpośrednio na urządzeniu — bez konieczności korzystania z chmury. Ta funkcjonalność odpowiada na rosnące potrzeby w zakresie lokalnych obliczeń AI z korzyściami w zakresie prywatności i opóźnień.
Architektura i przegląd sprzętu
Serce DGX Spark 64GB stanowi procesor NVIDIA GB10 Grace Blackwell Superchip, architektura zoptymalizowana pod kątem obciążeń AI z naciskiem na zunifikowany projekt pamięci. Zunifikowane 64GB pozwalają na załadowanie dużych modeli bezpośrednio do pamięci, co zmniejsza narzut przesyłania danych i przyspiesza zadania inferencji oraz dostrajania.
Łączność sieciową zapewnia zintegrowany kontroler NVIDIA ConnectX-7 NIC wspierający prędkości do 200 Gigabit Ethernet, umożliwiający wysokoprzepustowe i niskoopóźnieniowe połączenia dla klastrowania wielu jednostek DGX Spark. Połączenie mocy obliczeniowej, pamięci oraz sprzętu sieciowego czyni to urządzenie kompaktowym, lecz potężnym osobistym superkomputerem AI.
Platforma działa pod kontrolą DGX OS, specjalistycznego systemu operacyjnego NVIDIA przeznaczonego do obciążeń AI, oraz zawiera stos oprogramowania AI zoptymalizowany za pomocą bibliotek CUDA-X AI i wsparcia dla popularnych frameworków. Zapewnia to przyspieszenie działania od razu dla PyTorch, Ollama, vLLM i innych środowisk uruchomieniowych oraz dostęp do otwartych dużych modeli językowych, np. Nemotron.
Skalowalność dzięki NVIDIA Sync Cluster Assistant
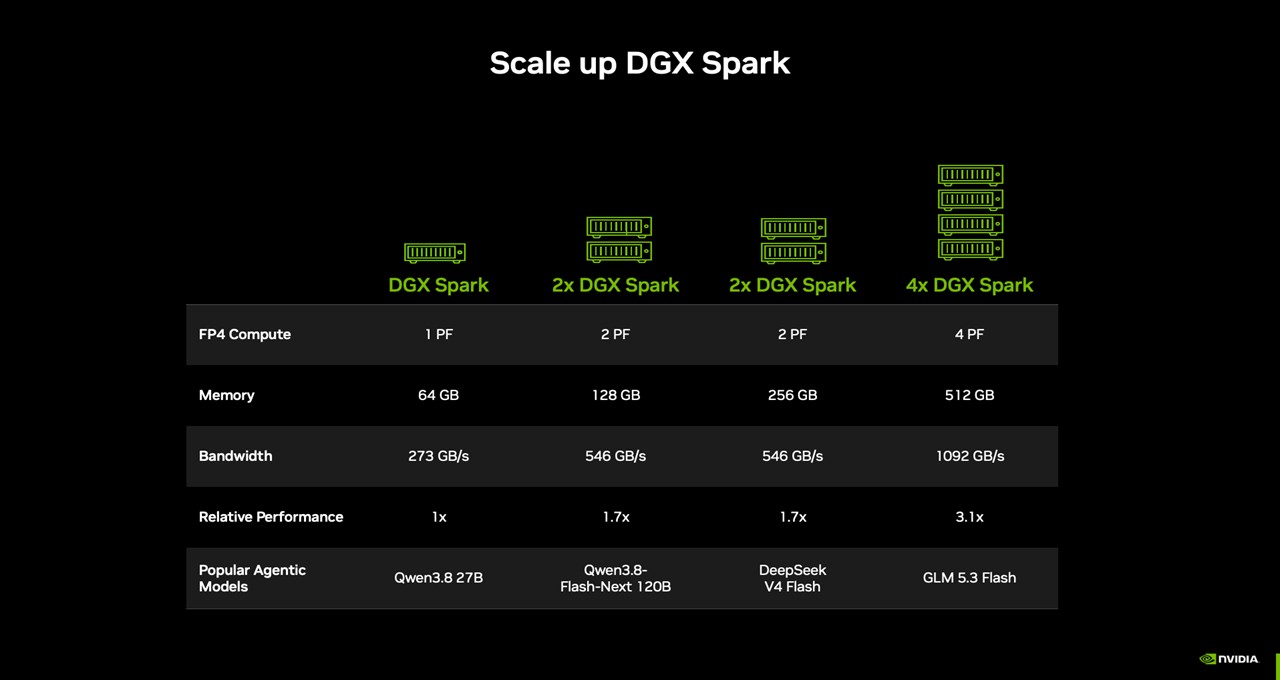
Kluczową innowacją DGX Spark 64GB jest jego bezproblemowa skalowalność możliwa dzięki NVIDIA Sync Cluster Assistant. To oprogramowanie zarządza klastrowaniem dwóch jednostek DGX Spark po ich złączach ConnectX-7 NIC za pomocą kabla QSFP bez konieczności ręcznej konfiguracji sieci lub oprogramowania.
Połączenie dwóch jednostek 64GB zapewnia łącznie 128GB zunifikowanej pamięci, co pozwala efektywnie uruchamiać modele do 200 miliardów parametrów i dostarcza do 1,7 razy wydajności pojedynczej jednostki. Testy wewnętrzne NVIDIA z modelem Qwen 3.8 27B wskazują na rzeczywistą skalowalność mocy i pojemności wykraczającą poza proste podwojenie pamięci.
Sync Cluster Assistant automatycznie rozpoznaje podłączone węzły, weryfikuje stan urządzeń i konfiguruje sieć, upraszczając przejście od środowisk jedno- do wielowęzłowych. Jednorodne stosy oprogramowania we wszystkich węzłach oznaczają, że programiści nie muszą dostosowywać wdrożeń podczas skalowania.
Stos oprogramowania i narzędzia dla programistów
DGX Spark jest dostarczany z rozbudowanym ekosystemem oprogramowania AI NVIDIA, zaprojektowanym by przyspieszyć rozwój AI:
- **NVIDIA Agent Toolkit:** Wspiera lokalne autonomiczne agentowe AI realizujące złożone i wieloetapowe zadania.
- **Biblioteki CUDA-X AI:** Zapewniają przyspieszenie GPU dla obciążeń AI, w tym trenowania i inferencji.
- **Otwarte duże modele językowe:** Obejmuje dostęp do modeli takich jak Nemotron, gotowych do wdrożenia lub dostrajania.
- **Obsługiwane środowiska uruchomieniowe:** Kompatybilność z popularnymi runtime'ami jak Ollama, vLLM, llama.cpp, oraz PyTorch z CUDA, dając programistom elastyczność.
- **Nadchodzący NVIDIA Sync Model Launcher:** Graficzny interfejs oczekiwany, aby uprościć uruchamianie dużych modeli jak Qwen 3.8 27B na pojedynczych lub klastrowych jednostkach, zarządzając rozproszonym wykonaniem modeli i dostępem z laptopów.
Ten kompleksowy zestaw narzędzi pozwala na szybkie przejście od konfiguracji sprzętu do efektywnej pracy nad aplikacjami AI.
Przykładowy scenariusz 1: Uruchomienie trwałego agenta AI do kodowania i badań
**Użytkownik:** Programiści lub badacze potrzebujący ciągłego wsparcia AI w przeglądzie kodu, analizie dokumentów lub automatyzacji złożonych zadań.
**Wymagania:** Jeden DGX Spark 64GB z NVIDIA Agent Toolkit.
**Kroki:** 1. Włącz DGX Spark i uzyskaj dostęp do preinstalowanego stosu oprogramowania AI NVIDIA. 2. Wdróż autonomicznego agenta AI dostosowanego do analizy kodu lub dokumentów przy użyciu Agent Toolkit. 3. Zintegruj odpowiednie zestawy danych lub pliki projektowe z otoczeniem agenta. 4. Jeśli potrzeby wzrosną, sklastruj drugi DGX Spark 64GB za pomocą NVIDIA Sync Cluster Assistant, aby zwiększyć pojemność i uruchomić wiele równoczesnych agentów.
**Pożądany wynik:** Trwale działający lokalny agent AI, wspierający użytkownika w czasie rzeczywistym bez polegania na usługach chmurowych, korzystny dla procesów wymagających prywatności i niskich opóźnień.
**Uwagi:** Zarządzanie termiczne i odpowiednie zasilanie są kluczowe dla utrzymania ciągłej pracy. Wielkość modelu musi odpowiadać dostępnej pamięci i skalować się stosownie.
Przykładowy scenariusz 2: Wsparcie AI dla kreatywnych aplikacji na komputerach użytkowników
**Użytkownik:** Graficy lub profesjonaliści kreatywni chcący wykonywać wymagające zasobowo inferencje AI bez obciążania swoich komputerów.
**Wymagania:** DGX Spark dostępny w sieci lokalnej; urządzenia klienckie z kompatybilnym oprogramowaniem kreatywnym.
**Kroki:** 1. Hostuj modele inferencyjne AI (np. modele tekst-na-obraz lub językowe) na DGX Spark. 2. Uzyskaj dostęp do tych modeli z terminali użytkowników przez API lub warstwy integracji. 3. Wykorzystaj nadchodzący instalator pre-built Blendera, aby bezpośrednio stosować funkcje AI DGX Spark w przepływach kreatywnych.
**Pożądany wynik:** Inferencja modeli AI wykonywana na DGX Spark, odciążając komputery klienckie, poprawiając responsywność i pozwalając na korzystanie z bardziej złożonych zadań kreatywnych wspomaganych AI.
**Uwagi:** Niezawodność i przepustowość sieci wpływają na interaktywność; należy stosować bezpieczne metody uwierzytelniania i transferu danych.
Przykładowy scenariusz 3: Skalowanie obciążeń AI wraz z rosnącymi potrzebami
**Użytkownik:** Badacze AI lub małe przedsiębiorstwa zaczynające od średnich zadań, przewidujące potrzebę obsługi większych modeli lub równoczesnych inferencji.
**Wymagania:** Dwie jednostki DGX Spark 64GB połączone kablami QSFP.
**Kroki:** 1. Rozpocznij od pojedynczego systemu DGX Spark 64GB dla początkowych obciążeń AI. 2. Dodaj drugi system i połącz je przez złącza ConnectX-7 NIC. 3. Użyj NVIDIA Sync Cluster Assistant do wykrycia, konfiguracji i weryfikacji klastra wielowęzłowego. 4. Skaluj płynnie obciążenia AI wykorzystując podwojoną zunifikowaną pamięć i przyspieszoną komunikację międzywęzłową bez modyfikacji starych stosów oprogramowania.
**Pożądany wynik:** Zwiększona pojemność pozwalająca obsłużyć większe modele, dłuższe okna kontekstowe czy wiele zadań AI wykonywanych równocześnie.
**Uwagi:** Obecnie skalowanie jest ograniczone do dwóch węzłów fizycznych; licencjonowanie oprogramowania i konfiguracje sieci muszą być zgodne z dokumentacją NVIDIA.
Przykładowy scenariusz 4: Rozwój i dostrajanie Edge AI
**Użytkownik:** Data scientist i programiści AI pracujący nad aplikacjami Edge AI, które wymagają dostrajania modeli i inferencji na urządzeniu bez zależności od chmury.
**Wymagania:** System DGX Spark 64GB z DGX OS i dostępem do danych do dostrajania.
**Kroki:** 1. Wdróż bazowe modele mieszczące się w 64GB zunifikowanej pamięci. 2. Użyj bibliotek NVIDIA CUDA-X AI oraz PyTorch z CUDA do lokalnego dostrajania. 3. Testuj wdrożenia na urządzeniach brzegowych symulując warunki inferencji w czasie rzeczywistym przy użyciu lokalnego DGX Spark. 4. Dla skalowania połącz drugi DGX Spark 64GB za pomocą Sync Cluster Assistant, by obsłużyć bardziej złożone modele lub symulować wiele jednoczesnych aplikacji brzegowych.
**Pożądany wynik:** Programiści mogą szybko iterować nad projektami modeli i wdrożeniami z niskimi opóźnieniami, zachowując pełną kontrolę nad danymi i modelami.
**Uwagi:** Rozmiar zbiorów danych i złożoność modeli muszą mieścić się w ramach pamięci, chyba że skalowane przez klastry wielowęzłowe. Należy weryfikować wymagania dotyczące opóźnień i reaktywności w czasie rzeczywistym.
Kompatybilność, konserwacja i kwestie bezpieczeństwa
Utrzymanie spójnego środowiska sprzętowo-programowego pomiędzy jednostkami DGX Spark ułatwia niezawodność oraz aktualizacje. Organizacje powinny stosować najlepsze praktyki bezpieczeństwa dla ochrony danych i infrastruktury podczas wdrażania lokalnych klastrów AI.
Kopie zapasowe danych, modeli i konfiguracji pozostają w gestii użytkowników. Regularny monitoring stanu sprzętu i predykcyjne utrzymanie zapewniają dostępność i długowieczność systemu.
Segmentacja sieci i zapory są zalecane dla ochrony urządzeń w szerszych środowiskach IT. Użytkownicy powinni zapoznać się z dokumentacją NVIDIA dla szczegółowych procedur i wytycznych zgodności.
Platforma obsługuje wiodące frameworki AI i runtime'y dla szerokiej kompatybilności, jednak użytkownicy muszą potwierdzić integracje z preferowanymi narzędziami.
Dopasowanie produktu i ograniczenia
NVIDIA DGX Spark 64GB jest idealny dla profesjonalistów AI potrzebujących potężnej, kompaktowej lokalnej platformy AI z opcjami skalowania. Jego architektura sprawdza się przy przetwarzaniu danych poufnych, iteracyjnym rozwoju agentów AI oraz obciążeniach wymagających natychmiastowej lokalnej inferencji.
Mniej odpowiedni jest do bardzo dużych rozproszonych obciążeń AI przekraczających dwa węzły lub obsługujących setki miliardów parametrów. Organizacje z bardzo ograniczonym budżetem lub przestrzenią mogą uznać rozwiązanie za mniej praktyczne.
Koszt początkowy i specyficzne konfiguracje sprzętowe producenta wymagają oceny dostosowanej do potrzeb organizacji i infrastruktury.
Podsumowanie
NVIDIA DGX Spark 64GB zapewnia dobrze zintegrowaną, skalowalną i wydajną platformę do lokalnego rozwoju i wdrażania modeli AI. Łącząc zaawansowaną architekturę CPU-GPU, znaczną zunifikowaną pamięć i uproszczone klastrowanie przez NVIDIA Sync, upraszcza adopcję i skalowanie agentowych obciążeń AI całkowicie lokalnie.
Preinstalowane stosy oprogramowania i szerokie wsparcie frameworków umożliwiają natychmiastową produktywność programistów, a opcje klastrowania wielowęzłowego umożliwiają rozwój w miarę zwiększania się złożoności zadań AI.
Ten przegląd oparty jest wyłącznie na oficjalnej dokumentacji i wpisach blogowych NVIDIA z października 2026 roku, oferując analizę funkcji i scenariuszy użycia bez niezależnych testów ani benchmarków stron trzecich.
Źródła i oryginalne doniesienia
Read the original source ↗
Komentarze (0)
Nie ma jeszcze komentarzy.
Napisz komentarz
Komentarze publikujemy po moderacji. Nazwa i komentarz będą publiczne. Konto