
NVIDIA DGX Spark 64GB: Una Plataforma Local de IA Práctica para Desarrolladores e Investigadores
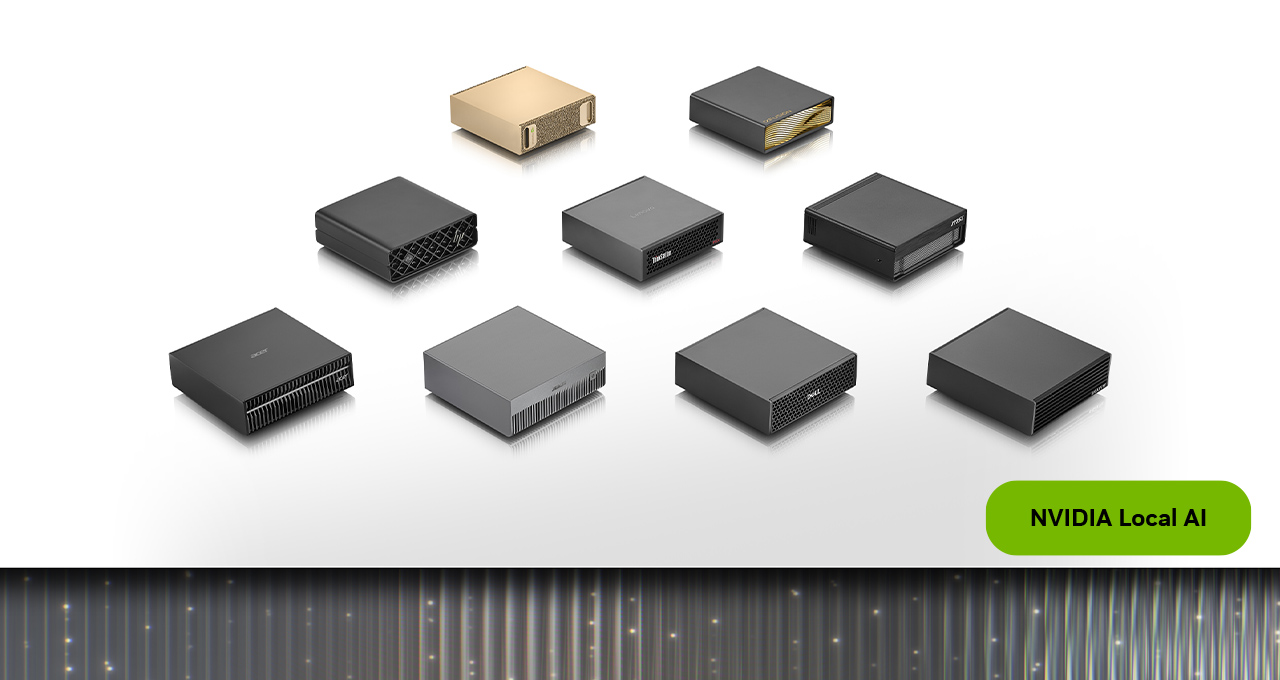
Image: NVIDIA · Source
El NVIDIA DGX Spark 64GB ofrece una solución compacta y escalable de supercomputación local de IA, que permite el despliegue y escalado de modelos de IA agenticos de hasta 100 mil millones de parámetros en el dispositivo. Soporta agrupación multi-nodo sin interrupciones y viene precargado con la pila de software de IA de NVIDIA para productividad inmediata.
Introducción al NVIDIA DGX Spark 64GB
El NVIDIA DGX Spark 64GB es una plataforma especializada de computación local para IA diseñada para potenciar a desarrolladores, investigadores y entusiastas de IA mediante la provisión de capacidades de IA potentes, privadas y escalables en las instalaciones. Desarrollado en alianza con proveedores líderes de hardware como Acer, ASUS, Dell, Gigabyte, HP y MSI, esta plataforma integra hardware avanzado y software optimizado para aplicaciones de IA agentica, inferencia, ajuste fino y tareas de ciencia de datos.
Con 64 GB de memoria unificada y el Superchip NVIDIA Grace Blackwell en su núcleo, el DGX Spark 64GB soporta la ejecución de modelos de lenguaje sustanciales —hasta 100 mil millones de parámetros directamente en el dispositivo— sin dependencia de infraestructura en la nube. Esta capacidad responde a la creciente demanda de cálculo local de IA con ventajas en privacidad y latencia.
Visión general arquitectónica y de hardware
En el corazón del DGX Spark 64GB se encuentra el Superchip NVIDIA GB10 Grace Blackwell, una arquitectura diseñada para optimizar cargas de trabajo de IA con especial enfoque en el diseño de memoria unificada. Los 64 GB de memoria unificada permiten cargar modelos grandes completamente en memoria, reduciendo la sobrecarga por movimiento de datos y acelerando tareas de inferencia y ajuste fino.
La conectividad se facilita mediante la NIC integrada NVIDIA ConnectX-7, que soporta hasta 200 Gigabit Ethernet, habilitando conexiones de alta velocidad y baja latencia para agrupar múltiples unidades DGX Spark. Esta combinación de poder de procesamiento, memoria y hardware de red posiciona al dispositivo como una supercomputadora personal compacta pero capaz.
La plataforma ejecuta DGX OS, el sistema operativo especializado de NVIDIA para cargas de trabajo de IA, y cuenta con una pila de software de IA optimizada con las librerías CUDA-X AI y soporte para frameworks ampliamente usados. Esta integración asegura aceleración inmediata para PyTorch, Ollama, vLLM y otros entornos de ejecución, junto con acceso a modelos de lenguaje abiertos como Nemotron.
Escalabilidad mediante NVIDIA Sync Cluster Assistant
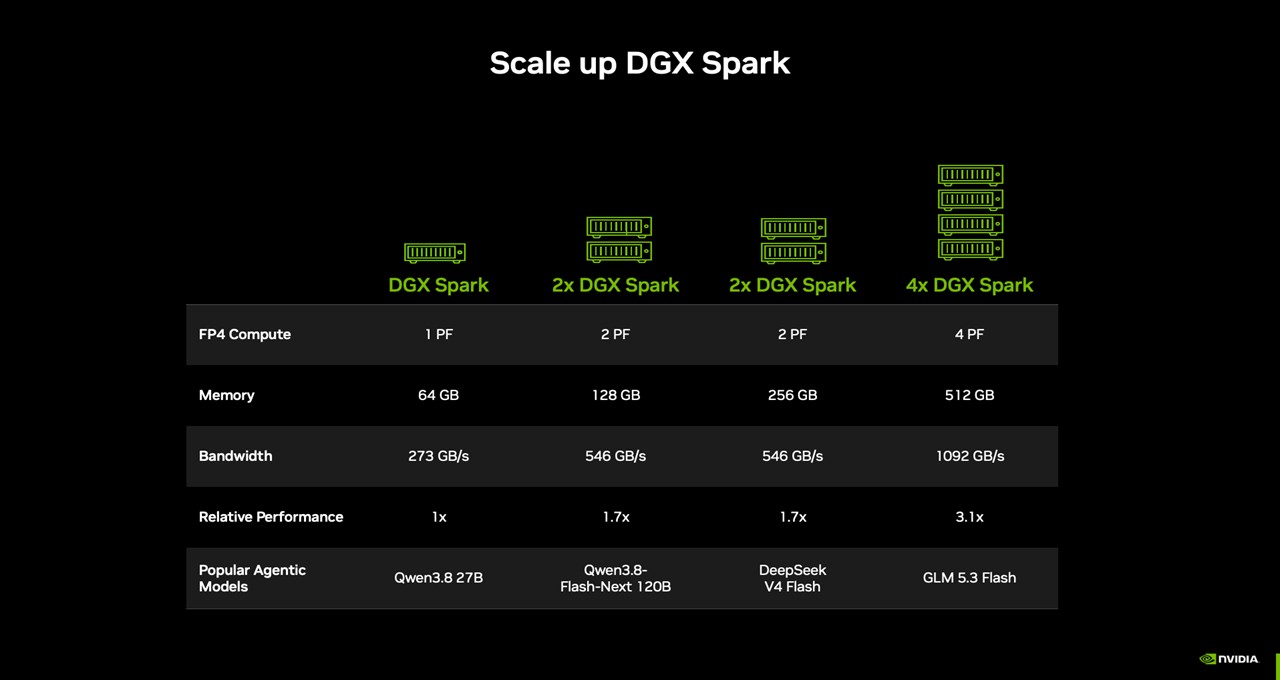
Una innovación clave del DGX Spark 64GB es su escalabilidad sin interrupciones habilitada por NVIDIA Sync Cluster Assistant. Este software orquesta el agrupamiento de dos unidades DGX Spark mediante sus NIC ConnectX-7 a través de un cable QSFP sin requerir configuración manual de red o software.
Al unir las dos unidades de 64GB se obtienen 128GB de memoria unificada, permitiendo efectivamente ejecutar modelos de hasta 200 mil millones de parámetros y entregar hasta 1.7 veces el rendimiento de una sola unidad. Las pruebas internas de NVIDIA con el modelo Qwen 3.8 27B indican una escalabilidad genuina en rendimiento y capacidad más allá de un simple doblado de memoria.
El Sync Cluster Assistant detecta automáticamente los nodos conectados, valida el estado del dispositivo y configura la red, simplificando la transición de entornos de nodo único a multi-nodo. Pilas de software uniformes entre nodos eliminan la necesidad de ajustes en las implementaciones al escalar.
Pila de software y herramientas para desarrolladores
DGX Spark viene preinstalado con un extenso ecosistema de software de IA de NVIDIA diseñado para acelerar el desarrollo de IA:
- **NVIDIA Agent Toolkit:** Soporta agentes autónomos locales de IA que realizan tareas complejas y de múltiples pasos.
- **Librerías CUDA-X AI:** Ofrecen rendimiento acelerado por GPU para cargas de trabajo de IA, incluyendo entrenamiento e inferencia.
- **Modelos de lenguaje grandes abiertos:** Incluye acceso a modelos como Nemotron para despliegue inmediato o ajuste fino.
- **Entornos de ejecución soportados:** Compatibilidad con entornos populares como Ollama, vLLM, llama.cpp y PyTorch con CUDA, brindando flexibilidad a desarrolladores.
- **Próximo NVIDIA Sync Model Launcher:** Interfaz gráfica anticipada para simplificar el lanzamiento de modelos grandes como Qwen 3.8 27B en unidades simples o en clústeres, gestionando la ejecución distribuida del modelo y acceso desde laptops.
Este conjunto integral permite a los usuarios pasar rápidamente desde la configuración de hardware al desarrollo productivo de aplicaciones de IA.
Flujo de trabajo ejemplo 1: Ejecutar un agente de IA persistente para codificación e investigación
**Usuario:** Desarrolladores de software o investigadores que requieren soporte continuo de IA para revisión de código, análisis de documentos o automatización de tareas complejas.
**Requisitos previos:** Una unidad DGX Spark 64GB con NVIDIA Agent Toolkit.
**Pasos:** 1. Encender el DGX Spark y acceder a la pila de software de IA preinstalada de NVIDIA. 2. Desplegar un agente autónomo de IA adaptado para análisis de código o documentos usando el Agent Toolkit. 3. Integrar conjuntos de datos o archivos de proyecto relevantes en el entorno del agente. 4. Si aumentan las demandas, agrupar una segunda unidad DGX Spark 64GB con NVIDIA Sync Cluster Assistant para aumentar capacidad y ejecutar múltiples agentes simultáneos.
**Resultado exitoso:** Un agente local de IA en ejecución continua, capaz de asistir a los usuarios en tiempo real sin depender de servicios en la nube, beneficiando flujos de trabajo que requieren privacidad y baja latencia.
**Consideraciones:** La gestión térmica y la suficiencia de suministro eléctrico son críticas para operación sostenida. El tamaño del modelo debe alinearse con la memoria disponible, escalando en consecuencia.
Flujo de trabajo ejemplo 2: Apoyo a aplicaciones creativas potenciadas por IA en PC de usuario
**Usuario:** Diseñadores gráficos o profesionales creativos que desean realizar inferencia IA intensiva sin sobrecargar sus computadoras personales.
**Requisitos previos:** DGX Spark accesible en red local; dispositivos cliente con software creativo compatible.
**Pasos:** 1. Alojar modelos de inferencia IA (por ejemplo, modelos de texto a imagen o lenguaje) en DGX Spark. 2. Desde estaciones de trabajo del usuario, acceder a estos modelos mediante APIs o capas de integración. 3. Utilizar futuro instalador preconstruido para Blender que permita emplear características IA de DGX Spark directamente dentro de flujos creativos.
**Resultado exitoso:** La inferencia de modelos IA se realiza en DGX Spark, descargando la demanda computacional de las PC cliente, mejorando la capacidad de respuesta y permitiendo tareas creativas asistidas por IA más complejas.
**Consideraciones:** La fiabilidad y el ancho de banda de red pueden afectar la interactividad; deben implementarse estrategias seguras de autenticación y transferencia de datos.
Flujo de trabajo ejemplo 3: Escalar cargas de trabajo de IA con demandas crecientes
**Usuario:** Investigadores en IA o pequeñas empresas que comienzan con tareas de escala media pero anticipan necesidades de modelos más grandes o inferencias concurrentes.
**Requisitos previos:** Dos unidades DGX Spark 64GB interconectadas mediante cables QSFP.
**Pasos:** 1. Empezar con un sistema DGX Spark 64GB para cargas base de IA. 2. Añadir una segunda unidad y conectarlas mediante sus NIC ConnectX-7. 3. Usar NVIDIA Sync Cluster Assistant para detectar, configurar y verificar el clúster multi-nodo. 4. Escalar cargas de trabajo IA aprovechando la memoria unificada duplicada y la comunicación acelerada entre nodos sin modificar pilas de software existentes.
**Resultado exitoso:** Capacidad aumentada para manejar modelos más grandes, ventanas de contexto extendidas o múltiples tareas de IA simultáneas.
**Consideraciones:** La escalabilidad actual está limitada a dos nodos físicos; las licencias de software y configuraciones de red deben cumplir las directrices documentadas por NVIDIA.
Flujo de trabajo ejemplo 4: Desarrollo y ajuste fino de IA en el borde
**Usuario:** Científicos de datos y desarrolladores de IA que trabajan en aplicaciones de IA en el borde que requieren ajuste fino y inferencia en dispositivo sin dependencia de la nube.
**Requisitos previos:** Un sistema DGX Spark 64GB con DGX OS y acceso a conjuntos de datos para ajuste fino.
**Pasos:** 1. Desplegar modelos base iniciales que quepan dentro de los 64GB de memoria unificada. 2. Utilizar las librerías CUDA-X AI de NVIDIA y PyTorch con CUDA para realizar tareas de ajuste fino localmente. 3. Probar despliegues modelo en dispositivos de borde simulando condiciones de inferencia en tiempo real usando el DGX Spark local. 4. Para escalabilidad, enlazar una segunda unidad DGX Spark 64GB con Sync Cluster Assistant para manejar modelos más complejos o simulaciones concurrentes de aplicaciones en borde.
**Resultado exitoso:** Los desarrolladores pueden iterar rápidamente en diseño y despliegue de modelos con ciclos de retroalimentación de baja latencia, manteniendo control total sobre datos y modelos.
**Consideraciones:** El tamaño del conjunto de datos y la complejidad del modelo deben permanecer dentro de las limitaciones de memoria salvo que se escale con clústeres multi-nodo. Los desarrolladores deben verificar que la latencia y capacidad de respuesta en tiempo real cumplan los requisitos de la aplicación.
Compatibilidad, mantenimiento y consideraciones de seguridad
Mantener un entorno consistente de software y hardware entre unidades DGX Spark favorece la fiabilidad y simplifica actualizaciones. Las organizaciones deben incorporar las mejores prácticas de seguridad para proteger datos sensibles e infraestructura cuando implementan clústeres locales de IA.
Las copias de seguridad de datos, modelos y configuraciones son responsabilidad del usuario. La monitorización regular del estado del hardware y el mantenimiento predictivo apoyan el tiempo de actividad y la longevidad del sistema.
Se recomienda segmentación de red y cortafuegos para proteger los dispositivos cuando se integran en entornos IT más amplios. Los usuarios deben consultar la documentación de NVIDIA para procedimientos detallados y directrices de cumplimiento.
La plataforma soporta frameworks y entornos de ejecución líderes para asegurar amplia compatibilidad, pero los usuarios deben verificar integraciones específicas con sus herramientas de software elegidas.
Ajuste del producto y limitaciones
El NVIDIA DGX Spark 64GB es ideal para profesionales de IA que requieren una plataforma compacta local potente con opciones escalables. Su arquitectura es adecuada para manejo confidencial de datos, desarrollo iterativo de agentes IA y cargas de trabajo que demandan inferencia local inmediata.
No es tan apropiado para tareas de IA distribuidas a escala extremadamente grande que excedan clústeres de dos nodos o aquellas que requieran cientos de miles de millones de parámetros. Además, organizaciones con presupuestos muy ajustados o espacio físico limitado pueden encontrar la solución menos manejable.
El costo inicial y configuraciones específicas de hardware del fabricante requieren evaluación alineada con necesidades organizacionales e infraestructura.
Conclusión
El NVIDIA DGX Spark 64GB proporciona una plataforma bien integrada, escalable y eficiente para desarrollo y despliegue local de modelos IA. Combinando arquitectura avanzada CPU-GPU, memoria unificada sustancial y agrupamiento simplificado vía NVIDIA Sync, facilita la adopción y escalado de cargas agenticas de IA completamente en las instalaciones.
Las pilas de software precargadas y el soporte amplio de frameworks habilitan productividad inmediata para desarrolladores, mientras que las opciones de clúster multi-nodo acompañan el crecimiento en la complejidad de cargas IA.
Esta reseña se basa exclusivamente en documentación oficial y publicaciones de blog de NVIDIA fechadas en octubre de 2026, ofreciendo un análisis de características y flujos de trabajo sin evaluación práctica independiente ni benchmarking de terceros.
Fuentes e informes originales
Read the original source ↗
Comentarios (0)
Aún no hay comentarios.
Escribe un comentario
Los comentarios se publican tras moderación. Tu nombre y comentario serán públicos. Cuenta