
NVIDIA DGX Spark 64GB: Käytännöllinen paikallinen tekoälyalusta kehittäjille ja tutkijoille
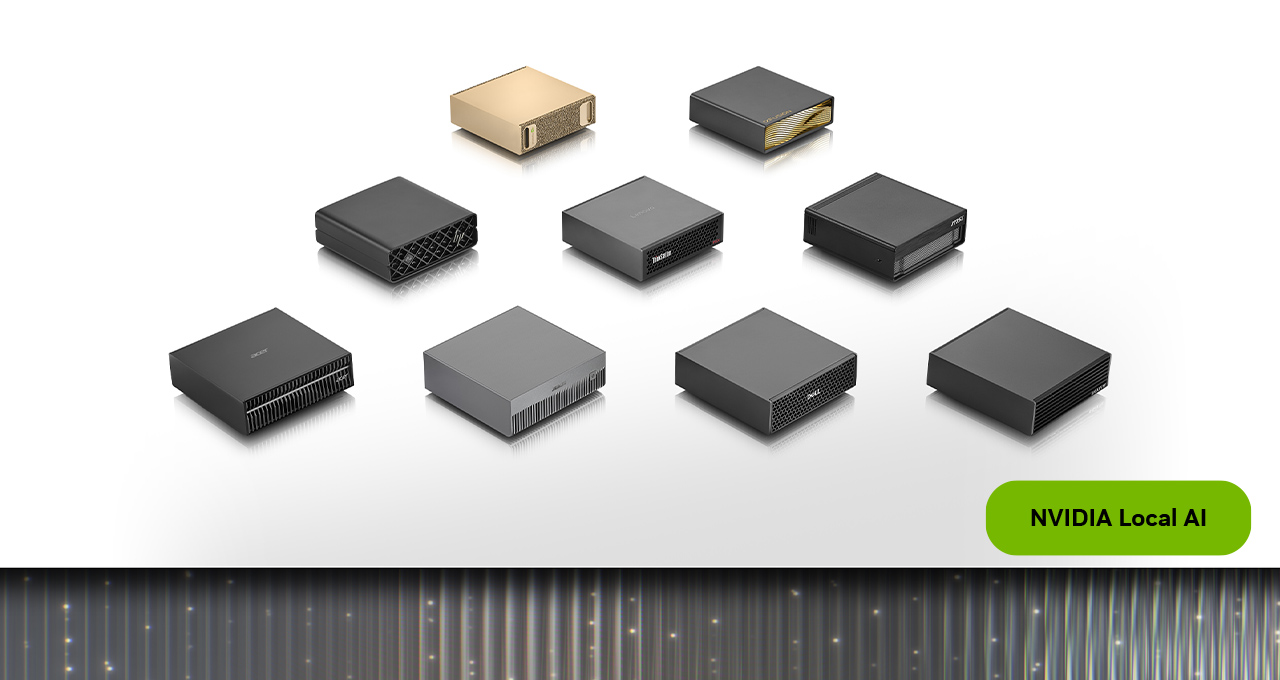
Kuva: NVIDIA · Lähde
NVIDIA DGX Spark 64GB tarjoaa kompaktin, skaalautuvan paikallisen tekoälysuperlaskennan ratkaisun, joka mahdollistaa agenttipohjaisten tekoälymallien käyttöönoton ja skaalaamisen jopa 100 miljardin parametrin kokoisena laitteessa. Se tukee saumattoman monisolmuklusteroinnin ja toimitetaan valmiiksi ladattuna NVIDIA:n tekoälyohjelmistopinolla tuottavuuden aloittamiseksi välittömästi.
Johdanto NVIDIA DGX Spark 64GB:een
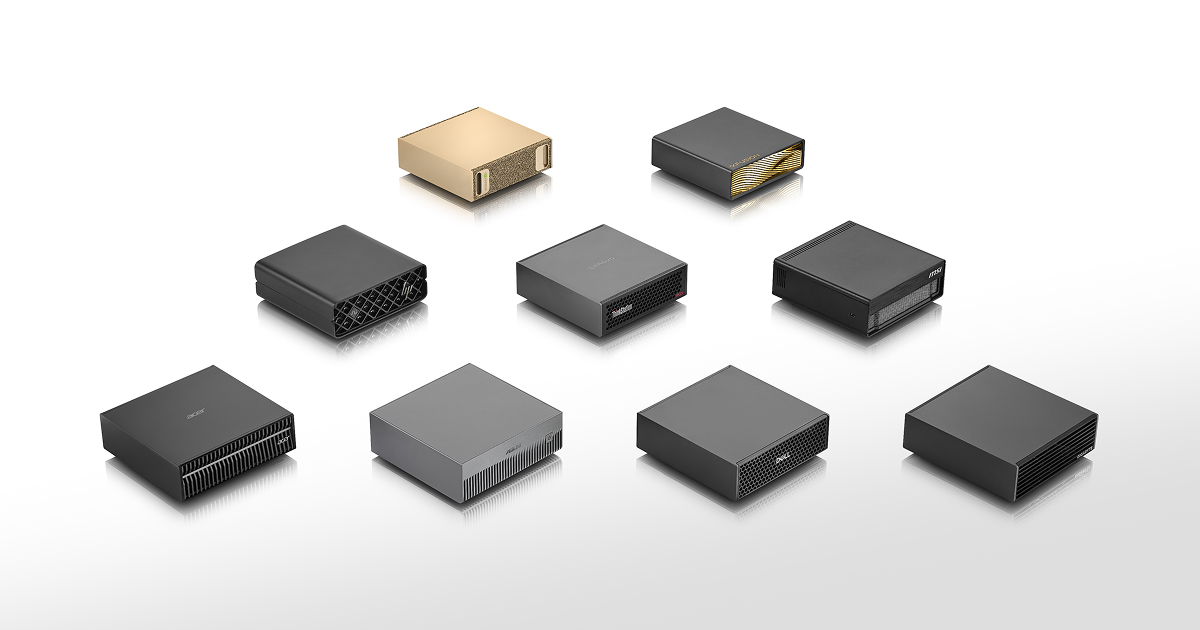
NVIDIA DGX Spark 64GB on erikoistunut paikallinen tekoälylaskenta-alusta, joka on suunniteltu voimaannuttamaan tekoälykehittäjiä, tutkijoita ja harrastajia tarjoamalla tehokkaat, yksityiset ja skaalautuvat tekoälyominaisuudet yrityksen omilla tiloilla. Alusta on kehitetty yhteistyössä johtavien laitteistotoimittajien, kuten Acerin, ASUS:n, Dellin, Gigabyten, HP:n ja MSI:n kanssa, ja siinä yhdistyy edistynyt laitteisto ja ohjelmisto, joka on optimoitu agenttipohjaisiin tekoälysovelluksiin, päättelyyn, hienosäätöön ja datatieteeseen.
64 gigatavun yhtenäisellä muistilla ja NVIDIA Grace Blackwell Superchipin ytimellä DGX Spark 64GB tukee huomattavien kielimallien suorittamista – jopa 100 miljardin parametrin kokoisia malleja suoraan laitteessa – ilman pilvi-infrastruktuurista riippuvuutta. Tämä vastaa kasvavaan paikallisen tekoälylaskennan tarpeeseen yksityisyydestä ja latenssista hyötyen.
Arkkitehtuuri ja laitteiston yleiskatsaus
DGX Spark 64GB:n sydämessä on NVIDIA GB10 Grace Blackwell Superchip, arkkitehtuuri, joka on räätälöity optimoimaan tekoälykuormia yhtenäisen muistin suunnittelun ympärillä. 64 gigatavun yhtenäinen muisti mahdollistaa suurten mallien lataamisen kokonaan muistiin, mikä vähentää datan siirtämisen kustannuksia ja nopeuttaa päättelyä sekä hienosäätöä.
Verkottuminen hoituu integroidulla NVIDIA ConnectX-7 verkkokortilla, joka tukee jopa 200 gigabitin Ethernetiä, mahdollistaen suuren läpäisyn ja pienen viiveen yhteydet useiden DGX Spark -yksiköiden klusterointiin. Tämä yhdistelmä prosessointitehoa, muistia ja verkkolaitteistoa tekee laitteesta kompaktin mutta tehokkaan henkilökohtaisen tekoälysuperlaskimen.
Alusta käyttää DGX OS -käyttöjärjestelmää, NVIDIA:n tekoälytyökuormiin räätälöityä käyttöjärjestelmää, ja sisältää tekoälyohjelmistopinon, joka on optimoitu CUDA-X AI -kirjastoilla ja suosittujen kehysten tuella. Tämä varmistaa valmisakseleraation PyTorchille, Ollamalle, vLLM:lle ja muille ajourille sekä pääsyn avoimiin suuriin kielimalleihin, kuten Nemotron.
Skaalautuvuus NVIDIA Sync Cluster Assistantilla
DGX Spark 64GB:n merkittävä innovaatio on sen saumaton skaalautuvuus, joka on toteutettu NVIDIA Sync Cluster Assistant -ohjelmistolla. Tämä ohjelmisto orkestroi kahden DGX Spark -yksikön klusteroinnin ConnectX-7 -verkkokorttien kautta QSFP-kaapelin avulla ilman manuaalista verkko- tai ohjelmistokonfigurointia.
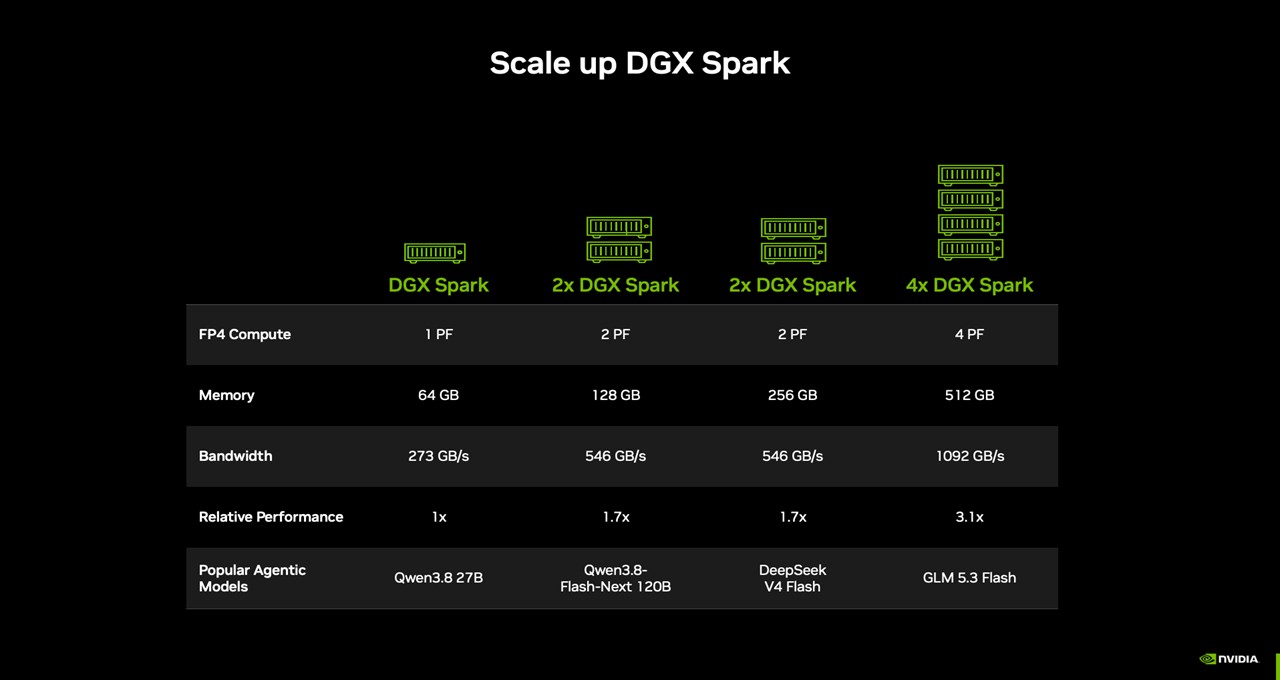
Yhdistämällä kaksi 64 GB yksikköä saavutetaan 128 gigatavua yhtenäistä muistia, mikä tehokkaasti mahdollistaa jopa 200 miljardin parametrin mallien suorittamisen ja tarjoaa jopa 1,7-kertaisen suorituskyvyn verrattuna yhteen yksikköön. NVIDIA:n sisäiset testit Qwen 3.8 27B -mallilla osoittavat todellista suorituskyvyn ja kapasiteetin skaalautuvuutta, ei pelkästään muistin kaksinkertaistumista.
Sync Cluster Assistant tunnistaa automaattisesti yhdistetyt solmut, vahvistaa laitteiden tilan ja konfiguroi verkon, mikä yksinkertaistaa siirtymisen yksisolmusta monisolmuihin ympäristöihin. Yhtenäiset ohjelmistopinot solmujen välillä tarkoittavat, että kehittäjien ei tarvitse säätää julkaisujaan skaalaamisen yhteydessä.
Ohjelmistopino ja kehitystyökalut
DGX Spark sisältää valmiiksi asennetun laajan NVIDIA-tekoälyohjelmistoekosysteemin, joka nopeuttaa tekoälyn kehitystä:
- **NVIDIA Agent Toolkit:** Tukee paikallisia autonomisia tekoälyagentteja, jotka suorittavat monimutkaisia ja monivaiheisia tehtäviä.
- **CUDA-X AI -kirjastot:** Tarjoavat GPU-kiihdytettyä suorituskykyä tekoälykuormille, mukaan lukien koulutus ja päättely.
- **Avoimet suuret kielimallit:** Sisältää pääsyn malleihin kuten Nemotron välittömään käyttöönottoon tai hienosäätöön.
- **Tuetut runtime-ympäristöt:** Yhteensopivuus suosittujen runtime-ympäristöjen, kuten Ollama, vLLM, llama.cpp ja PyTorch CUDA -versioiden kanssa, tarjoaa joustavuutta kehittäjille.
- **Tulossa oleva NVIDIA Sync Model Launcher:** Graafinen käyttöliittymä, jonka odotetaan helpottavan suurten mallien, kuten Qwen 3.8 27B, käynnistämistä yksittäisissä tai klusteroiduissa yksiköissä ja hallitsemaan hajautettua mallien suorittamista ja pääsyä kannettavista tietokoneista.
Tämä kattava työkalupaketti mahdollistaa käyttäjien siirtymisen nopeasti laitteiston asetuksista tuottavaan tekoälysovellusten kehitykseen.
Esimerkki 1: Jatkuvan tekoälyagentin käyttö koodaukseen ja tutkimukseen
**Käyttäjä:** Ohjelmistokehittäjät tai tutkijat, jotka tarvitsevat jatkuvaa tekoälytukea koodin tarkastukseen, dokumenttien analysointiin tai monimutkaisten tehtävien automatisointiin.
**Edellytykset:** Yksi DGX Spark 64GB NVIDIA Agent Toolkitillä.
**Vaiheet:** 1. Käynnistä DGX Spark ja käytä esiasennettua NVIDIA tekoälyohjelmistopakettia. 2. Ota käyttöön autonominen tekoälyagentti, joka on räätälöity koodin tai dokumenttien analyysiin Agent Toolkitin avulla. 3. Integroi asiaankuuluvat tietoaineistot tai projektitiedostot agentin ympäristöön. 4. Jos tarve kasvaa, klusteroi toinen DGX Spark 64GB NVIDIA Sync Cluster Assistantin avulla kapasiteetin lisäämiseksi ja useiden samanaikaisten agenttien pyörittämiseksi.
**Onnistunut lopputulos:** Jatkuvasti toimiva paikallinen tekoälyagentti, joka pystyy auttamaan käyttäjiä reaaliajassa ilman pilvipalveluihin tukeutumista, hyödyttäen työnkulkuja, jotka vaativat yksityisyyttä ja pientä viivettä.
**Huomioitavaa:** Lämmönhallinta ja virtalähteen riittävyys ovat kriittisiä kestävälle toiminnalle. Mallin koko tulee sovittaa käytettävissä olevaan muistiin ja tarvittaessa skaalata vastaavasti.
Esimerkki 2: Tekoälyn tukemat luovat sovellukset käyttäjien tietokoneilla
**Käyttäjä:** Graafiset suunnittelijat tai luovat ammattilaiset, jotka haluavat suorittaa resursseja vaativaa tekoälyn päättelyä ilman, että henkilökohtaiset tietokoneet kuormittuvat.
**Edellytykset:** DGX Spark käytettävissä paikallisessa verkossa; asiakaslaitteet käyttävät yhteensopivia luovia ohjelmistoja.
**Vaiheet:** 1. Isännöi tekoälypäättelymalleja (esim. teksti-kuva-mallit tai kielimallit) DGX Sparkissa. 2. Käyttäjien työasemilta pääsy näihin malleihin API:en tai integraatiokerrosten kautta. 3. Hyödynnä tulevaa Blenderin esiasennuspakettia, jonka avulla DGX Sparkin tekoälyominaisuudet voidaan käyttää suoraan luovissa työnkuluissa.
**Onnistunut lopputulos:** Tekoälymallien päättely suoritetaan DGX Sparkilla, jolloin laskentakuorma kevenee asiakkaiden tietokoneilla, paranee reagointikyky ja mahdollistuu monimutkaisempien tekoälyä hyödyntävien luovien tehtävien tekeminen.
**Huomioitavaa:** Verkon luotettavuus ja kaistanleveys voivat vaikuttaa interaktiivisuuteen; turvallinen todennus ja tietojen siirron hallinta ovat tarpeen.
Esimerkki 3: Tekoälykuormien skaalaaminen kasvavien tarpeiden mukaan
**Käyttäjä:** Tekoälytutkijat tai pienet yritykset, jotka aloittavat keskisuuret tehtävät mutta ennakoivat tarvetta suuremmille malleille tai rinnakkaisille inferensseille.
**Edellytykset:** Kaksi DGX Spark 64GB -yksikköä yhdistetty QSFP-kaapeleilla.
**Vaiheet:** 1. Aloita yhdellä DGX Spark 64GB -järjestelmällä perus tekoälykuormia varten. 2. Lisää toinen yksikkö ja yhdistä ne ConnectX-7 verkkokorteilla. 3. Käytä NVIDIA Sync Cluster Assistantia tunnistamaan, konfiguroimaan ja validoimaan monisolmuklusteri. 4. Skaalaa tekoälykuormia saumattomasti kaksinkertaisella yhtenäisellä muistilla ja nopeutetulla solmuvälisellä viestinnällä ilman ohjelmistopinon muutoksia.
**Onnistunut lopputulos:** Parannettu kapasiteetti suurempien mallien, laajennettujen kontekstialueiden tai useiden samanaikaisten tekoälytehtävien käsittelemiseen.
**Huomioitavaa:** Nykyinen skaalaus rajoittuu kahteen fyysiseen solmuun; ohjelmistolisenssit ja verkkokonfiguraatiot tulee olla NVIDIA:n dokumentaation mukaisia.
Esimerkki 4: Reuna-TEKOÄLY-kehitys ja hienosäätö
**Käyttäjä:** Data-analyytikot ja tekoälykehittäjät, jotka työskentelevät reuna-TEKOÄLY-sovellusten parissa, jotka vaativat paikallista mallien hienosäätöä ja päättelyä ilman pilvivakioita.
**Edellytykset:** DGX Spark 64GB -järjestelmä, jossa DGX OS ja pääsy hienosäätöön tarvittaviin datariveihin.
**Vaiheet:** 1. Ota käyttöön alkumallit, jotka mahtuvat 64 GB yhtenäiseen muistiin. 2. Käytä NVIDIA CUDA-X AI -kirjastoja ja PyTorchia CUDA-tuella paikalliseen hienosäätöön. 3. Testaa mallin käyttöönotto reuna-laitteissa simuloimalla reaaliaikaista päättelyä paikallisella DGX Sparkilla. 4. Skaalautuvuutta varten yhdistä toinen DGX Spark 64GB Sync Cluster Assistantilla käsittelemään monimutkaisempia malleja tai useita rinnakkaisia reuna-sovellusten simulointeja.
**Onnistunut lopputulos:** Kehittäjät voivat nopeasti iteratiivisesti kehittää mallien suunnittelua ja käyttöönottoa pienten viiveiden kanssa, säilyttäen täydellisen hallinnan datoihin ja malleihin.
**Huomioitavaa:** Datarivejä ja mallien kompleksisuutta on hallittava muistirajoitusten puitteissa, ellei skaalata monisolmuklusterilla. Kehittäjien tulisi varmistaa viiveiden ja reaaliaikaisuuden vastaavuus sovellusvaatimuksiin.
Yhteensopivuus, ylläpito ja tietoturva
Yhtenäisen ohjelmisto- ja laitteistoalustan ylläpito DGX Spark -yksiköillä parantaa luotettavuutta ja yksinkertaistaa päivityksiä. Organisaatioiden tulisi noudattaa parhaita tietoturvakäytäntöjä suojatakseen arkaluonteisia tietoja ja infrastruktuuria paikallisia tekoälyklustereita käyttäessään.
Datan, mallien ja konfiguraatioiden varmuuskopiointi on käyttäjän vastuulla. Säännöllinen laitteiston kunnon seuranta ja ennakoiva huolto tukevat käyttöaikaa ja järjestelmän kestävyyttä.
Verkkojen segmentointi ja palomuurit ovat suositeltavia laitteiden suojaamiseksi integroituna laajempaan IT-ympäristöön. Käyttäjien tulee tutustua NVIDIA:n dokumentaatioon yksityiskohtaisia menettelytapoja ja vaatimustenmukaisuutta varten.
Alusta tukee johtavia tekoälykehyksiä ja runtime-ympäristöjä laajan yhteensopivuuden varmistamiseksi, mutta käyttäjien tulee varmentaa integraatiot valittujen ohjelmistotyökalujen kanssa.
Tuotteen soveltuvuus ja rajoitukset
NVIDIA DGX Spark 64GB sopii tekoälyammattilaisille, jotka tarvitsevat tehokkaan, kompaktin paikallisen tekoälylaskenta-alustan skaalautuvilla vaihtoehdoilla. Sen arkkitehtuuri soveltuu luottamuksellisten tietojen käsittelyyn, iteratiiviseen agenttipohjaiseen tekoälyn kehitykseen ja tehtäviin, jotka vaativat viipymättömän paikallisen päättelyn.
Se ei sovi erittäin laajamittaisiin hajautettuihin tekoälytehtäviin, jotka ylittävät kahden solmun klusterit tai vaativat satojen miljardien parametrien malleja. Lisäksi organisaatiot, joilla on hyvin tiukat budjetit tai rajalliset tilat, saattavat pitää ratkaisua vähemmän hallittavana.
Alkukinnotus ja valmistajakohtaiset laitteistokokoonpanot edellyttävät arviointia organisaation tarpeiden ja infrastruktuurin mukaan.
Yhteenveto
NVIDIA DGX Spark 64GB tarjoaa hyvin integroidun, skaalautuvan ja tehokkaan alustan paikalliseen tekoälymallin kehitykseen ja käyttöönottoon. Yhdistämällä edistyneen CPU-GPU-arkkitehtuurin, merkittävän yhtenäisen muistin ja virtaviivaistetun klusteroinnin NVIDIA Syncin avulla se helpottaa agenttipohjaisten tekoälykuormien hallintaa kokonaan yrityksen omissa tiloissa.
Esiasennetut ohjelmistopinot ja laaja kehysten tuki mahdollistavat välittömän kehittäjätuottavuuden, kun taas monisolmuklusterointivaihtoehdot tukevat tekoälykuormien kasvavaa monimutkaisuutta.
Tämä katsaus perustuu yksinomaan NVIDIA:n viralliseen tuotemateriaaliin ja blogikirjoituksiin lokakuulta 2026, tarjoten ominaisuus- ja työnkulkuanalyysin ilman itsenäistä käytännön arviointia tai kolmannen osapuolen vertailuja.
Lähteet ja alkuperäiset raportit
Lue alkuperäinen lähde ↗
Kommentit (0)
Ei vielä kommentteja. Aloita keskustelu.
Kirjoita kommentti
Kommentit julkaistaan moderoinnin jälkeen. Nimesi ja kommenttisi näkyvät julkisesti. Tili