
NVIDIA DGX Spark 64GB: En Praktisk Lokal AI-plattform for Utviklere og Forskere
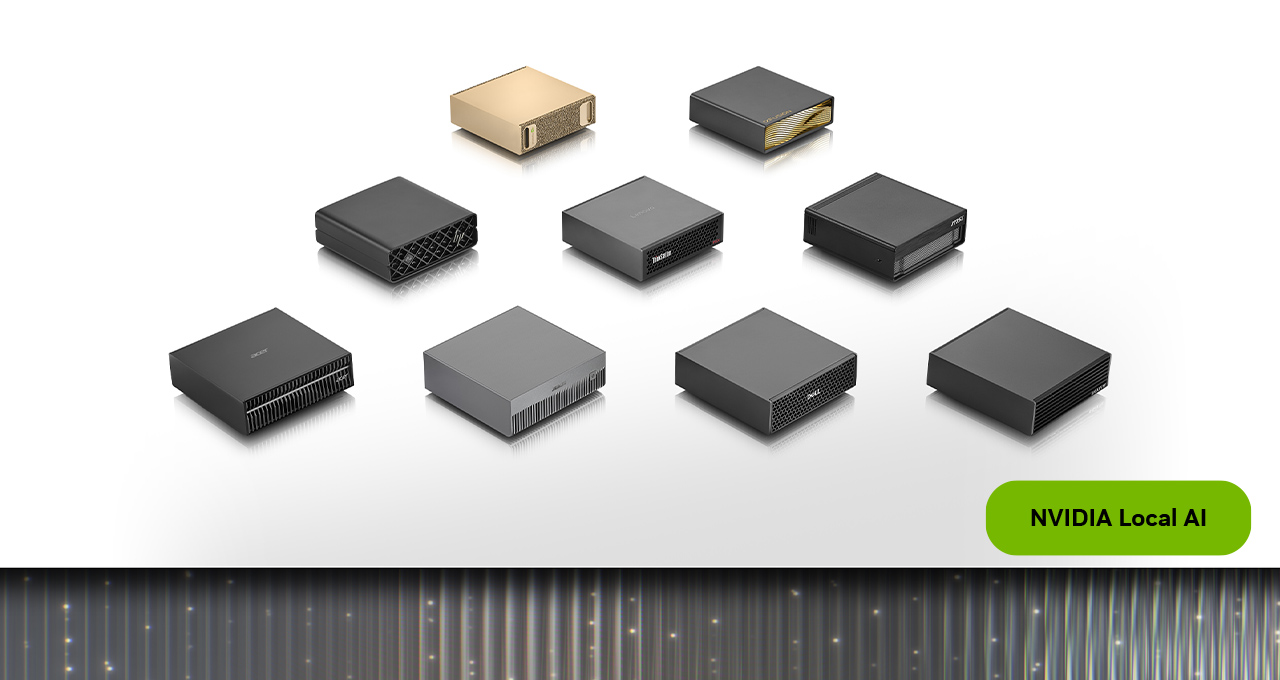
Bilde: NVIDIA · Kilde
NVIDIA DGX Spark 64GB tilbyr en kompakt, skalerbar lokal AI-superdatertjeneste som muliggjør distribusjon og skalering av agentiske AI-modeller med opptil 100 milliarder parametere på enheten. Den støtter sømløs fler-nodeklynging og leveres forhåndslastet med NVIDIAs AI-programvarepakke for umiddelbar produktivitet.
Introduksjon til NVIDIA DGX Spark 64GB
NVIDIA DGX Spark 64GB er en spesialisert lokal AI-dataplattform designet for å styrke AI-utviklere, forskere og entusiaster ved å tilby kraftige, private og skalerbare AI-muligheter på stedet. Utviklet i samarbeid med ledende maskinvareleverandører som Acer, ASUS, Dell, Gigabyte, HP og MSI, integrerer denne plattformen avansert maskinvare og programvare optimalisert for agentiske AI-applikasjoner, inferens, finjustering og datavitenskapelige oppgaver.
Med 64GB enhetlig minne og NVIDIA Grace Blackwell Superchip i kjernen, støtter DGX Spark 64GB kjøring av store språkmodeller – opptil 100 milliarder parametere direkte på enheten – uten avhengighet til skyinfrastruktur. Denne kapasiteten møter voksende etterspørsel etter lokal AI-beregning med fordeler innen personvern og lav forsinkelse.
Arkitektur- og maskinvareoversikt
Kjernen i DGX Spark 64GB er NVIDIA GB10 Grace Blackwell Superchip, en arkitektur tilpasset for å optimalisere AI-arbeid med fokus på enhetlig minnedesign. Det 64GB enhetlige minnet tillater at store modeller lastes helt inn i minnet, noe som reduserer databevegelse og akselererer inferens og finjustering.
Nettverk blir muliggjort av den integrerte NVIDIA ConnectX-7 NIC, som støtter opptil 200 Gigabit Ethernet, og muliggjør høy gjennomstrømming og lav forsinkelse for klynging av flere DGX Spark-enheter. Denne kombinasjonen av prosessorkraft, minne og nettverksmaskinvare plasserer enheten som en kompakt, men kapabel personlig AI-superdatamaskin.
Plattformen kjører DGX OS, NVIDIAs spesialiserte operativsystem for AI-arbeidsoppgaver, og inkluderer en AI-programvarepakke optimalisert med CUDA-X AI-biblioteker og støtte for mye brukte rammeverk. Denne integrasjonen sikrer akselerasjon rett ut av boksen for PyTorch, Ollama, vLLM og andre kjøretider samt tilgang til åpne store språkmodeller som Nemotron.
Skalerbarhet gjennom NVIDIA Sync Cluster Assistant
En nøkkelinnovasjon i DGX Spark 64GB er dens sømløse skalerbarhet muliggjort av NVIDIA Sync Cluster Assistant. Denne programvaren orkestrerer klynging av to DGX Spark-enheter over deres ConnectX-7 NICs via en QSFP-kabel uten behov for manuell nettverks- eller programvarekonfigurasjon.
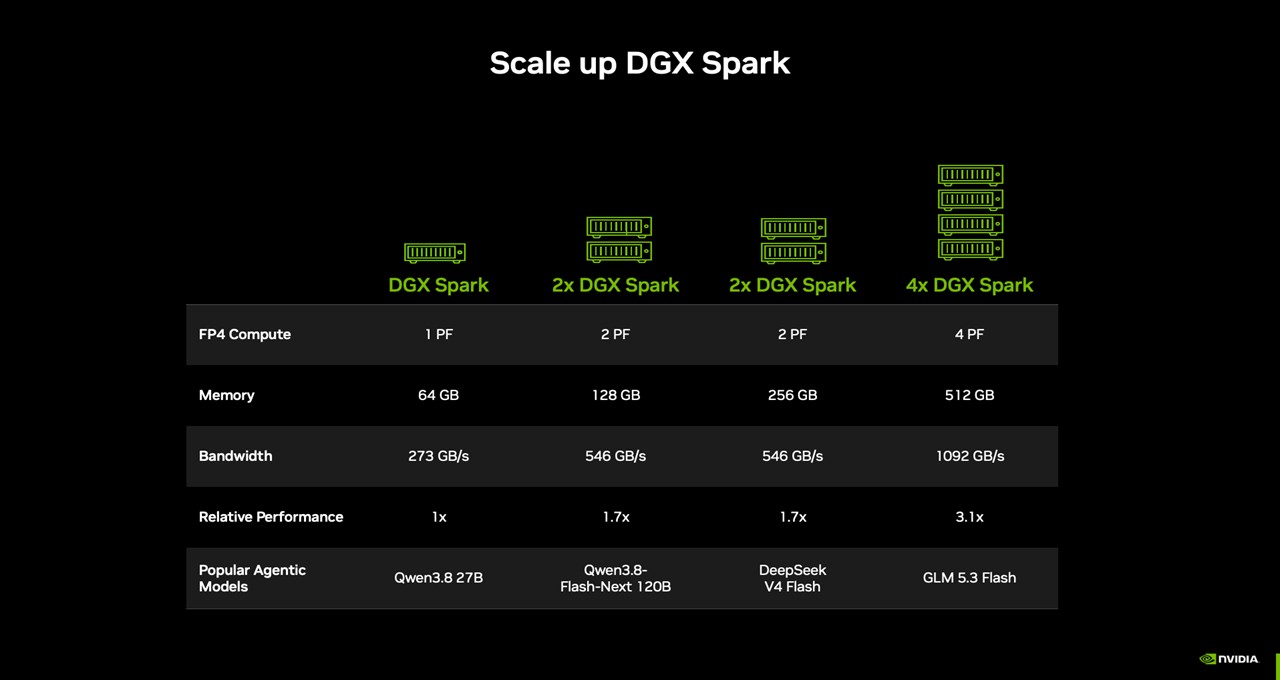
Ved å samle de to 64GB-enhetene oppnås 128GB enhetlig minne, som effektivt gjør det mulig å kjøre modeller opptil 200 milliarder parametere og leverer opptil 1,7 ganger ytelsen til en enkelt enhet. NVIDIAs interne testing med Qwen 3.8 27B-modellen indikerer ekte ytelses- og kapasitetsøkning utover bare en dobling av minnet.
Sync Cluster Assistant oppdager automatisk tilkoblede noder, validerer enhetsstatus og konfigurerer nettverket, og forenkler overgangen fra enkelt-node til multi-node miljøer. Enhetlige programvarepakker på tvers av noder betyr at utviklere ikke trenger å justere distribusjoner ved skalering.
Programvarestakk og utviklerverktøy
DGX Spark kommer forhåndsinstallert med et omfattende NVIDIA AI-programvareøkosystem designet for å fremskynde AI-utvikling:
- **NVIDIA Agent Toolkit:** Støtter lokale autonome AI-agenter som utfører komplekse og flerstegsoppgaver.
- **CUDA-X AI Libraries:** Gir GPU-akselerert ytelse for AI-arbeidsoppgaver inkludert trening og inferens.
- **Åpne store språkmodeller:** Inkluderer tilgang til modeller som Nemotron for umiddelbar distribusjon eller finjustering.
- **Støttede kjøretider:** Kompatibilitet med populære kjøretider som Ollama, vLLM, llama.cpp og PyTorch med CUDA, som gir fleksibilitet til utviklere.
- **Kommende NVIDIA Sync Model Launcher:** Et grafisk grensesnitt som forventes å forenkle lansering av store modeller som Qwen 3.8 27B på enkelt- eller klyngeenheter, samtidig som det håndterer distribuert modellkjøring og tilgang fra bærbare datamaskiner.
Dette omfattende verktøyssettet lar brukere raskt gå fra maskinvareoppsett til produktiv AI-applikasjonsutvikling.
Eksempel arbeidsflyt 1: Kjøre en vedvarende AI-agent for koding og forskning
**Bruker:** Programvareutviklere eller forskere som trenger kontinuerlig AI-støtte for kodegjennomgang, dokumentanalyse eller kompleks oppgaveautomatisering.
**Forutsetninger:** En DGX Spark 64GB med NVIDIA Agent Toolkit.
**Trinn:** 1. Slå på DGX Spark og få tilgang til den forhåndslastede NVIDIA AI-programvarepakken. 2. Distribuer en autonom AI-agent tilpasset kode- eller dokumentanalyse med Agent Toolkit. 3. Integrer relevante datasett eller prosjektfiler i agentens miljø. 4. Hvis behovet øker, kluster en andre DGX Spark 64GB med NVIDIA Sync Cluster Assistant for å øke kapasiteten og kjøre flere samtidige agenter.
**Vellykket resultat:** En kontinuerlig kjørende lokal AI-agent som kan assistere brukere i sanntid uten avhengighet av skyløsninger, gunstig for arbeidsflyter som krever personvern og lav forsinkelse.
**Vurderinger:** Termisk styring og tilstrekkelig strømforsyning er kritiske for vedvarende drift. Modellstørrelse må samsvare med tilgjengelig minne, og skaleres deretter.
Eksempel arbeidsflyt 2: Støtte for AI-drevne kreative applikasjoner på brukernes PC-er
**Bruker:** Grafiske designere eller kreative fagfolk som ønsker å utføre ressurskrevende AI-inferens uten å belaste sine personlige datamaskiner.
**Forutsetninger:** DGX Spark tilgjengelig på lokalt nettverk; klientenheter som kjører kompatibel kreativ programvare.
**Trinn:** 1. Verts AI-inferensmodeller (for eksempel tekst-til-bilde eller språkmodeller) på DGX Spark. 2. Fra brukerens arbeidsstasjoner, få tilgang til disse modellene via API-er eller integrasjonslag. 3. Bruk kommende Blender forhåndsinstallerer for direkte bruk av DGX Spark AI-funksjoner innen kreative arbeidsflyter.
**Vellykket resultat:** AI-modellinferens utføres på DGX Spark, noe som avlaster beregningsbehovet fra klient-PC-er, forbedrer respons og muliggjør mer komplekse AI-støttede kreative oppgaver.
**Vurderinger:** Nettverksstabilitet og båndbredde kan påvirke interaktivitet; sikre autentiserings- og datatransportstrategier bør håndheves.
Eksempel arbeidsflyt 3: Skalering av AI-arbeidsoppgaver med økende behov
**Bruker:** AI-forskere eller små virksomheter som starter med middels store oppgaver, men forventer behov for større modeller eller flere samtidige inferenser.
**Forutsetninger:** To DGX Spark 64GB-enheter koblet sammen med QSFP-kabler.
**Trinn:** 1. Start med ett enkelt DGX Spark 64GB-system for grunnleggende AI-arbeidsoppgaver. 2. Legg til en andre enhet og koble dem via deres ConnectX-7 NICs. 3. Bruk NVIDIA Sync Cluster Assistant for å oppdage, konfigurere og verifisere multi-node-klyngen. 4. Skaler AI-arbeidsbelastninger sømløst ved å utnytte doblet enhetlig minne og akselerert kommunikasjon mellom noder uten å modifisere eksisterende programvarepakker.
**Vellykket resultat:** Økt kapasitet til å håndtere større modeller, lengre kontekstvinduer eller flere samtidige AI-oppgaver.
**Vurderinger:** Nåværende skalering er begrenset til to fysiske noder; programvarelisensiering og nettverkskonfigurasjoner må overholde NVIDIAs dokumenterte retningslinjer.
Eksempel arbeidsflyt 4: Edge AI-utvikling og finjustering
**Bruker:** Datascientister og AI-utviklere som jobber med edge AI-applikasjoner som krever modellfinjustering og inferens på enheten uten skyavhengighet.
**Forutsetninger:** En DGX Spark 64GB med DGX OS og tilgang til datasett for finjustering.
**Trinn:** 1. Distribuer initielle basismodeller som passer innenfor 64GB enhetlig minne. 2. Bruk NVIDIA CUDA-X AI-biblioteker og PyTorch med CUDA for å utføre lokal finjustering. 3. Test modellimplementering på edge-enheter ved å simulere sanntidsinferens ved hjelp av den lokale DGX Spark. 4. For skalerbarhet, lenk en andre DGX Spark 64GB med Sync Cluster Assistant for å håndtere mer komplekse modeller eller flere samtidige edge-simuleringer.
**Vellykket resultat:** Utviklere kan raskt iterere på modelldesign og distribusjoner med lav forsinkelse og full kontroll over data og modeller.
**Vurderinger:** Datasettstørrelse og modellkompleksitet må holdes innenfor minnebegrensninger med mindre multi-node-klynging benyttes. Utviklere bør verifisere at forsinkelse og sanntidsrespons møter kravene til applikasjonen.
Kompatibilitet, vedlikehold og sikkerhetsoverveielser
Å opprettholde et konsistent programvare- og maskinvaremiljø på tvers av DGX Spark-enheter øker pålitelighet og forenkler oppdateringer. Organisasjoner bør implementere sikkerhetsbeste praksis for å beskytte sensitiv data og infrastruktur ved distribusjon av lokale AI-klynger.
Backup av data, modeller og konfigurasjoner er brukerens ansvar. Regelmessig overvåking av maskinvarens helse og prediktivt vedlikehold støtter oppetid og systemlevetid.
Nettverkssegmentering og brannmurer anbefales for å sikre enhetene når de integreres i bredere IT-miljøer. Brukere bør konsultere NVIDIAs dokumentasjon for detaljerte prosedyrer og samsvarsrutiner.
Plattformen støtter ledende AI-rammeverk og kjøretider for å sikre bred kompatibilitet, men brukere må verifisere spesifikke integrasjoner med sine valgte programvareverktøy.
Produktpassform og begrensninger
NVIDIA DGX Spark 64GB er ideell for AI-profesjonelle som trenger en kraftig, kompakt lokal AI-dataplattform med skalerbare alternativer. Dens arkitektur egner seg for konfidensiell datahåndtering, iterativ AI-agentutvikling og arbeidsoppgaver som krever umiddelbar lokal inferens.
Den er mindre passende for ekstremt store distribuerte AI-oppgaver som overskrider to-node klynger eller krever hundrevis av milliarder parametere. Organisasjoner med svært stramme budsjetter eller begrenset fysisk plass kan finne løsningen mindre håndterbar.
Den innledende kostnaden og maskinvarekonfigurasjoner spesifikke for produsent krever evaluering i samsvar med organisatoriske behov og infrastruktur.
Konklusjon
NVIDIA DGX Spark 64GB tilbyr en godt integrert, skalerbar og effektiv plattform for lokal AI-modellutvikling og distribusjon. Ved å kombinere avansert CPU-GPU-arkitektur, betydelig enhetlig minne og strømlinjeformet klynging via NVIDIA Sync, forenkles adopsjon og skalering av agentiske AI-arbeidsoppgaver helt på stedet.
Forhåndslastede programvarepakker og bredt rammeverkstøtte muliggjør umiddelbar produktivitet for utviklere, mens multi-node klynger gir rom for økende kompleksitet i AI-arbeidsoppgaver.
Denne gjennomgangen er eksklusivt basert på offisiell NVIDIA produktdokumentasjon og blogginnlegg datert oktober 2026, og tilbyr en funksjons- og arbeidsflytanalyse uten uavhengig praktisk evaluering eller tredjeparts benchmarking.
Kilder og originalrapportering
Les originalkilden ↗
Kommentarer (0)
Ingen kommentarer ennå. Start diskusjonen.
Skriv en kommentar
Kommentarer publiseres etter moderering. Ditt navn og kommentar vil være synlige offentlig. Konto