
NVIDIA DGX Spark 64GB: Eine Praktische Lokale KI-Plattform für Entwickler und Forscher
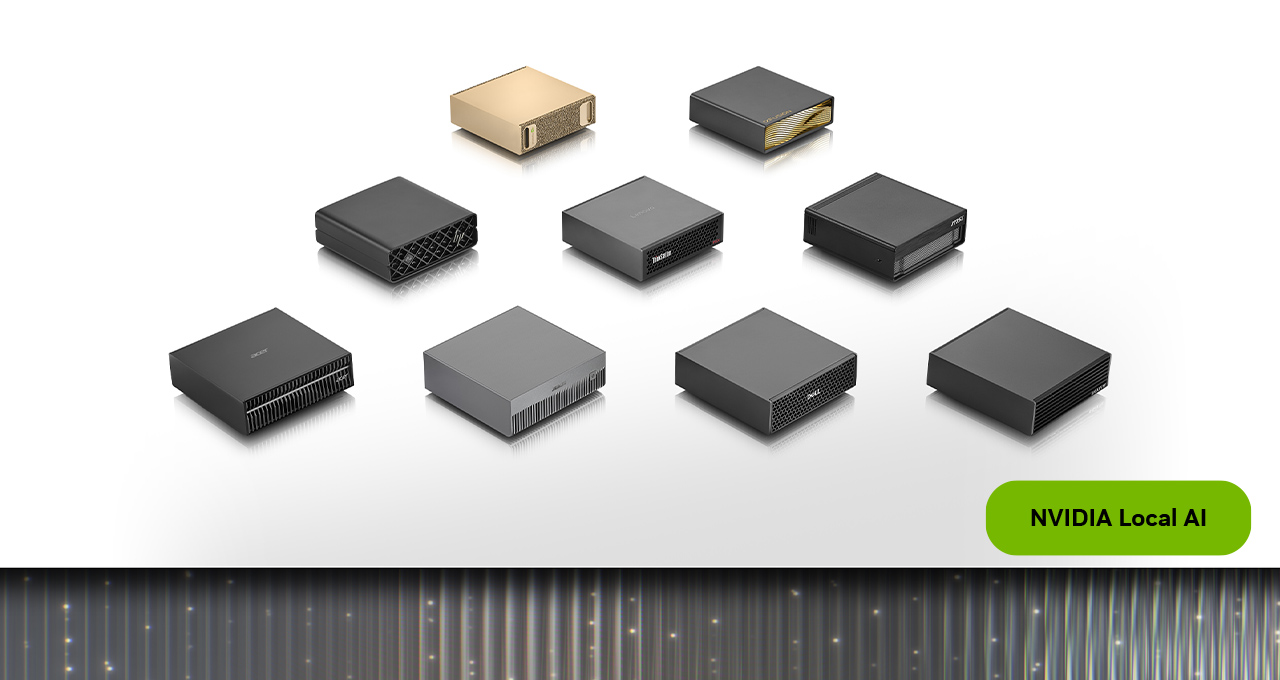
Image: NVIDIA · Source
Der NVIDIA DGX Spark 64GB bietet eine kompakte, skalierbare lokale Supercomputing-Lösung für KI, die die Bereitstellung und Skalierung agentischer KI-Modelle mit bis zu 100 Milliarden Parametern direkt auf dem Gerät ermöglicht. Er unterstützt nahtloses Multi-Node-Clustering und ist vorinstalliert mit NVIDIAs KI-Software-Stack für sofortige Produktivität.
Einführung in den NVIDIA DGX Spark 64GB
Der NVIDIA DGX Spark 64GB ist eine spezialisierte lokale KI-Computing-Plattform, die KI-Entwickler, Forscher und Enthusiasten befähigt, indem sie leistungsstarke, private und skalierbare KI-Fähigkeiten vor Ort bereitstellt. Entwickelt in Partnerschaft mit führenden Hardwareanbietern wie Acer, ASUS, Dell, Gigabyte, HP und MSI, integriert diese Plattform fortschrittliche Hardware und Software, die für agentische KI-Anwendungen, Inferenz, Feinabstimmung und Data-Science-Aufgaben optimiert ist.
Mit 64 GB einheitlichem Speicher und dem NVIDIA Grace Blackwell Superchip im Kern unterstützt der DGX Spark 64GB die Ausführung umfangreicher Sprachmodelle – bis zu 100 Milliarden Parameter direkt auf dem Gerät – ohne Abhängigkeit von Cloud-Infrastruktur. Diese Fähigkeit erfüllt wachsende Anforderungen an lokale KI-Berechnung mit Vorteilen bei Datenschutz und Latenz.
Architektur- und Hardwareübersicht
Im Zentrum des DGX Spark 64GB steht der NVIDIA GB10 Grace Blackwell Superchip, eine Architektur, die darauf ausgelegt ist, KI-Workloads mit Fokus auf einheitliches Speicherdesign zu optimieren. Die 64 GB einheitlicher Speicher ermöglichen das vollständige Laden großer Modelle in den Speicher, wodurch der Datenbewegungsaufwand reduziert und Inferenz- sowie Feinabstimmungsaufgaben beschleunigt werden.
Die Vernetzung wird durch die integrierte NVIDIA ConnectX-7 Netzwerkkarte ermöglicht, die bis zu 200 Gigabit Ethernet unterstützt und so Hochdurchsatz- und Niedriglatenzverbindungen für das Clustern mehrerer DGX Spark-Einheiten ermöglicht. Diese Kombination aus Rechenleistung, Speicher und Netzwerk-Hardware positioniert das Gerät als kompakte, dennoch leistungsfähige persönliche KI-Supercomputer.
Die Plattform läuft unter DGX OS, dem spezialisierten Betriebssystem von NVIDIA für KI-Workloads, und beinhaltet einen KI-Software-Stack, der mit CUDA-X AI-Bibliotheken optimiert und für weit verbreitete Frameworks unterstützt ist. Diese Integration gewährleistet sofortige Beschleunigung für PyTorch, Ollama, vLLM und andere Laufzeiten sowie Zugriff auf offene große Sprachmodelle wie Nemotron.
Skalierbarkeit durch NVIDIA Sync Cluster Assistant
Eine zentrale Innovation des DGX Spark 64GB ist seine nahtlose Skalierbarkeit, ermöglicht durch den NVIDIA Sync Cluster Assistant. Diese Software orchestriert das Clustern von zwei DGX Spark Einheiten über ihre ConnectX-7 NICs via QSFP-Kabel, ohne dass eine manuelle Netzwerk- oder Softwarekonfiguration notwendig ist.
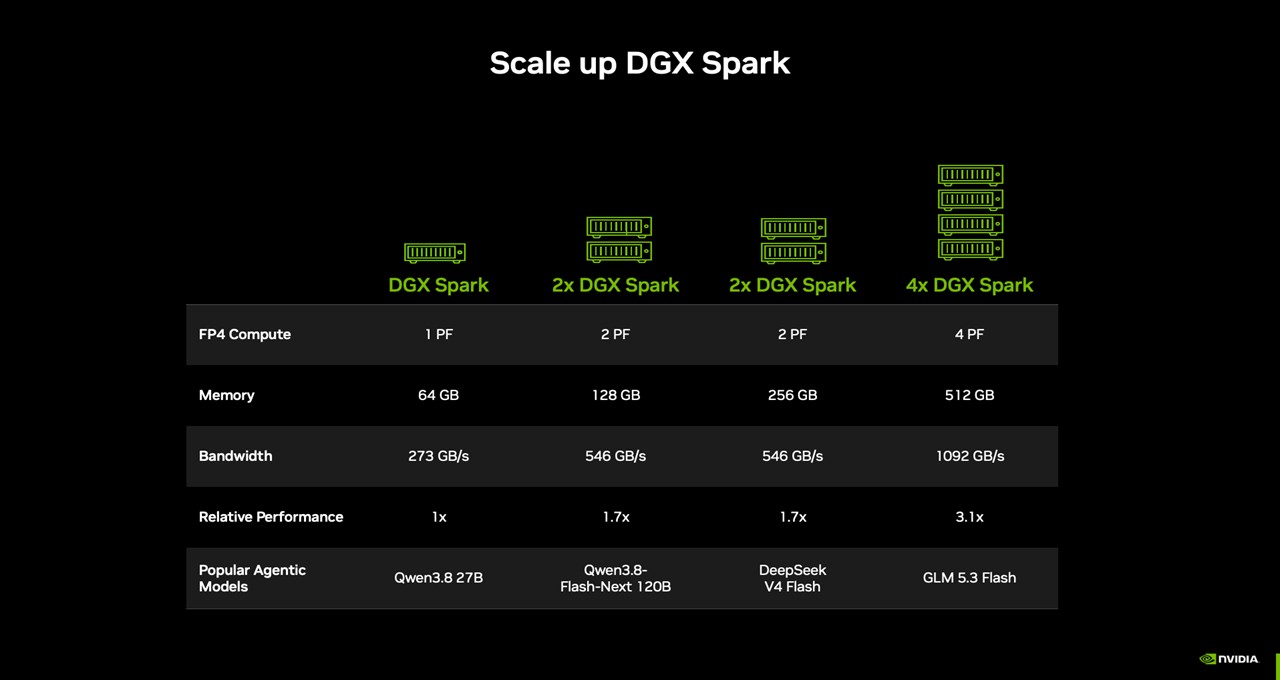
Durch das Zusammenlegen der beiden 64GB-Einheiten ergeben sich 128 GB einheitlicher Speicher, was effektiv die Ausführung von Modellen mit bis zu 200 Milliarden Parametern erlaubt und bis zu 1,7-mal die Leistung einer einzelnen Einheit liefert. Interne Tests von NVIDIA mit dem Qwen 3.8 27B Modell zeigen echte Skalierbarkeit in Leistung und Kapazität, die über eine bloße Speicherverdoppelung hinausgeht.
Der Sync Cluster Assistant erkennt automatisch verbundene Knoten, validiert den Gerätezustand und konfiguriert das Netzwerk, was den Übergang von Einzelknoten- zu Mehrknoten-Umgebungen vereinfacht. Einheitliche Software-Stacks über alle Knoten hinweg bedeuten, dass Entwickler ihre Deployments beim Skalieren nicht anpassen müssen.
Software-Stack und Entwickler-Tools
DGX Spark wird mit einem umfangreichen NVIDIA KI-Software-Ökosystem vorinstalliert geliefert, das die KI-Entwicklung beschleunigt:
- **NVIDIA Agent Toolkit:** Unterstützt lokale autonome KI-Agenten, die komplexe und mehrstufige Aufgaben ausführen.
- **CUDA-X AI Bibliotheken:** Liefern GPU-beschleunigte Leistung für KI-Workloads einschließlich Training und Inferenz.
- **Offene Große Sprachmodelle:** Beinhaltet Zugriff auf Modelle wie Nemotron für sofortige Bereitstellung oder Feinabstimmung.
- **Unterstützte Laufzeiten:** Kompatibilität mit beliebten Laufzeiten wie Ollama, vLLM, llama.cpp und PyTorch mit CUDA, bietet Flexibilität für Entwickler.
- **Bevorstehender NVIDIA Sync Model Launcher:** Eine grafische Oberfläche, die voraussichtlich das Starten großer Modelle wie Qwen 3.8 27B auf einzelnen oder geclusterten Einheiten vereinfacht, dabei verteilte Modellausführung und Zugriff von Laptops aus verwaltet.
Dieses umfassende Toolset ermöglicht es Nutzern, schnell von der Hardwareeinrichtung zur produktiven KI-Anwendungsentwicklung überzugehen.
Beispiel-Workflow 1: Ausführen eines persistenten KI-Agenten für Programmierung und Forschung
**Nutzer:** Softwareentwickler oder Forscher, die fortlaufende KI-Unterstützung für Code-Review, Dokumentenanalyse oder komplexe Automatisierung benötigen.
**Voraussetzungen:** Ein DGX Spark 64GB mit NVIDIA Agent Toolkit.
**Schritte:** 1. DGX Spark einschalten und auf den vorinstallierten NVIDIA KI-Software-Stack zugreifen. 2. Einen autonomen KI-Agenten bereitstellen, der auf Code- oder Dokumentenanalyse mit dem Agent Toolkit ausgelegt ist. 3. Relevante Datensätze oder Projektdaten in die Umgebung des Agenten integrieren. 4. Bei steigenden Anforderungen eine zweite DGX Spark 64GB mit dem NVIDIA Sync Cluster Assistant clustern, um Kapazität zu erhöhen und mehrere parallele Agenten zu betreiben.
**Erfolg:** Ein dauerhaft laufender lokaler KI-Agent, der Nutzern in Echtzeit assistiert ohne Abhängigkeit von Cloud-Diensten, ideal für Workflows, die Datenschutz und niedrige Latenz erfordern.
**Überlegungen:** Thermomanagement und ausreichende Stromversorgung sind für dauerhaften Betrieb kritisch. Die Modellgröße muss mit verfügbarem Speicher übereinstimmen und entsprechend skaliert werden.
Beispiel-Workflow 2: Unterstützung KI-gestützter kreativer Anwendungen auf Nutzer-PCs
**Nutzer:** Grafikdesigner oder Kreativprofis, die rechenintensive KI-Inferenz durchführen wollen, ohne ihre PCs zu belasten.
**Voraussetzungen:** Über das lokale Netzwerk zugänglicher DGX Spark; Client-Geräte mit kompatibler Kreativsoftware.
**Schritte:** 1. Hosting von KI-Inferenzmodellen (z. B. Text-zu-Bild oder Sprachmodelle) auf dem DGX Spark. 2. Zugriff auf diese Modelle von Nutzerarbeitsplätzen über APIs oder Integrationsschichten. 3. Nutzung des kommenden vorgefertigten Blender-Installers, um DGX Spark-KI-Funktionen direkt in kreative Workflows einzubinden.
**Erfolg:** Die KI-Modellinferenz erfolgt auf DGX Spark, entlastet die Client-PCs, verbessert die Reaktionsgeschwindigkeit und ermöglicht komplexere KI-unterstützte kreative Aufgaben.
**Überlegungen:** Netzwerkzuverlässigkeit und Bandbreite können die Interaktivität beeinflussen; sichere Authentifizierungs- und Datenübertragungsstrategien sollten umgesetzt werden.
Beispiel-Workflow 3: Skalierung von KI-Workloads bei wachsender Nachfrage
**Nutzer:** KI-Forscher oder kleine Unternehmen, die mit mittelgroßen Aufgaben starten, aber größere Modelle oder parallele Inferenz erwarten.
**Voraussetzungen:** Zwei DGX Spark 64GB Einheiten, verbunden mit QSFP-Kabeln.
**Schritte:** 1. Mit einem einzelnen DGX Spark 64GB System für Basis-KI-Workloads starten. 2. Eine zweite Einheit hinzufügen und mit deren ConnectX-7 NICs verbinden. 3. NVIDIA Sync Cluster Assistant verwenden, um den Multi-Node-Cluster zu erkennen, konfigurieren und zu überprüfen. 4. KI-Workloads nahtlos skalieren und dabei die verdoppelte einheitliche Speicherkapazität und beschleunigte Inter-Knoten-Kommunikation nutzen, ohne bestehende Software-Stacks ändern zu müssen.
**Erfolg:** Erhöhte Kapazität zur Bewältigung größerer Modelle, erweiterter Kontextfenster oder mehrerer gleichzeitiger KI-Aufgaben.
**Überlegungen:** Aktuelle Skalierung ist auf zwei physische Knoten begrenzt; Softwarelizenzen und Netzwerkkonfigurationen müssen den dokumentierten NVIDIA-Richtlinien entsprechen.
Beispiel-Workflow 4: Edge-KI-Entwicklung und Feinabstimmung
**Nutzer:** Datenwissenschaftler und KI-Entwickler, die an Edge-KI-Anwendungen arbeiten, welche lokale Feinabstimmung und Inferenz ohne Cloud-Abhängigkeit erfordern.
**Voraussetzungen:** Ein DGX Spark 64GB System mit DGX OS und Zugang zu Datensätzen für Feinabstimmung.
**Schritte:** 1. Einsatz von initialen Basismodellen, die in den 64GB einheitlichen Speicher passen. 2. Nutzung der NVIDIA CUDA-X AI-Bibliotheken und PyTorch mit CUDA für lokale Feinabstimmungsaufgaben. 3. Testen der Modellbereitstellungen auf Edge-Geräten durch Simulation von Echtzeit-Inferenzbedingungen mit lokalem DGX Spark. 4. Für Skalierbarkeit eine zweite DGX Spark 64GB Einheit mit Sync Cluster Assistant verbinden, um komplexere Modelle oder mehrere parallele Edge-Anwendungssimulationen zu ermöglichen.
**Erfolg:** Entwickler können schnell Iterationen im Modell-Design und Deployment mit niedriger Latenz durchführen sowie vollständige Kontrolle über Daten und Modelle behalten.
**Überlegungen:** Datensatzgröße und Modellkomplexität müssen innerhalb der Speichergrenzen bleiben, es sei denn, es wird auf Multi-Node-Clustering skaliert. Entwickler sollten sicherstellen, dass Latenz und Realtime-Reaktionsfähigkeit den Anwendungsanforderungen entsprechen.
Kompatibilität, Wartung und Sicherheitsaspekte
Die Aufrechterhaltung einer konsistenten Software- und Hardware-Umgebung über DGX Spark Einheiten hinweg unterstützt Zuverlässigkeit und vereinfacht Updates. Organisationen sollten Best Practices für Sicherheit implementieren, um sensible Daten und Infrastruktur bei lokalen KI-Clustern zu schützen.
Backups von Daten, Modellen und Konfigurationen liegen in der Verantwortung der Nutzer. Regelmäßige Überwachung des Hardwarezustands und vorausschauende Wartung fördern Betriebszeit und Systemlebensdauer.
Netzwerksegmentierung und Firewalls werden empfohlen, um die Geräte in größeren IT-Umgebungen abzusichern. Nutzer sollten die NVIDIA-Dokumentation für detaillierte Verfahren und Compliance-Richtlinien konsultieren.
Die Plattform unterstützt führende KI-Frameworks und Laufzeiten für breite Kompatibilität, Nutzer müssen jedoch spezifische Integrationen mit ihren gewählten Softwarewerkzeugen überprüfen.
Produktanpassung und Einschränkungen
Der NVIDIA DGX Spark 64GB ist ideal für KI-Fachleute, die eine leistungsstarke, kompakte lokale KI-Computing-Plattform mit skalierbaren Optionen benötigen. Seine Architektur eignet sich für vertrauliche Datenverarbeitung, iterative Entwicklung agentischer KI und Workloads, die sofortige lokale Inferenz erfordern.
Er ist weniger geeignet für extrem groß angelegte verteilte KI-Aufgaben, die über zwei Knoten hinausgehen oder Hunderte von Milliarden Parametern benötigen. Ebenso könnten Organisationen mit sehr begrenztem Budget oder wenig physischem Platz die Lösung als weniger praktikabel empfinden.
Die anfänglichen Kosten und herstellerspezifischen Hardwarekonfigurationen erfordern eine Bewertung entsprechend den organisatorischen Bedürfnissen und der vorhandenen Infrastruktur.
Fazit
Der NVIDIA DGX Spark 64GB bietet eine gut integrierte, skalierbare und effiziente Plattform für lokale KI-Modellentwicklung und -bereitstellung. Die Kombination aus fortschrittlicher CPU-GPU-Architektur, großem einheitlichem Speicher und vereinfachtem Clustering mittels NVIDIA Sync erleichtert die Einführung und Skalierung agentischer KI-Workloads vollständig vor Ort.
Vorinstallierte Software-Stacks und breite Framework-Unterstützung ermöglichen sofortige Entwicklerproduktivität, während Multi-Node-Clustering-Optionen das Wachstum in der Komplexität von KI-Workloads unterstützen.
Diese Bewertung basiert ausschließlich auf offizieller NVIDIA-Produktdokumentation und Blogbeiträgen vom Oktober 2026 und bietet eine Analyse von Funktionen und Workflows ohne unabhängige Praxistests oder Fremd-Benchmarking.
Quellen und Originalberichte
Read the original source ↗
Kommentare (0)
Noch keine Kommentare.
Kommentar schreiben
Kommentare erscheinen nach Moderation. Name und Kommentar werden öffentlich angezeigt. Konto